模型微调评测
企业在完成大语言模型的领域微调(Fine-Tuning)或知识蒸馏(Distillation)后,往往面临模型效果难以客观量化、上线质量缺乏保障的严峻挑战。微调后的模型在特定领域问答上是否真正超越了基准模型?是否存在严重的灾难性遗忘与通用能力退化?在真实业务语料测试集上的精确率、召回率与 F1 指标如何?
OmniCortex 提供了全流程开箱即用的 模型微调离线评测中心。系统无缝串联 AI 训练数据集与模型精调工坊 所产出的科学测试集(test.jsonl)或企业私有测试集,对微调后的候选模型(Candidate)与微调前的基准模型(Baseline)进行全自动化并排并发推理。通过严格基于真实标注(Ground Truth)的多维混淆矩阵计算、实体跨度精确差分比对、端到端完全一致率(Exact Match)度量以及「改进(Improved)/ 退化(Regressed)」五维胜负归因,帮助算法研发团队与业务质量专家以客观量化的数据指标精准把关模型质量,筑牢模型上线前最后一道质量防线。
核心机制与业务场景
1. 为什么企业需要专业的大模型微调评测?
在大模型企业级落地实践中,传统依赖人工主观抽样“盲测”或简单打分的评测方式已无法满足工业级质量交付标准:
- 盲目上线的质量盲区:缺乏客观量化的评测度量衡,模型微调后只能凭感觉在控制台尝试几句对话便草率上线,难以准确评估在海量真实业务场景下的泛化能力;
- 难以察觉的“灾难性遗忘”与能力退化:大模型在针对专有业务进行微调时,极易发生参数过拟合与基础常识遗忘(Regressed),在某些微调未覆盖的负样本或边缘用例上出现明显退化,单凭正向抽检极难暴露;
- 缺乏标准化的数学度量衡:人工评测标准不一、主观偏差大,企业亟需一套涵盖精确率(Precision)、召回率(Recall)、F1 分数以及整题完全一致率(Exact Match)的标准自动化度量体系;
- 评测流程割裂且难以复盘:传统评测依赖算法工程师手动编写脚本批量调度模型、解析文本并生成 Excel,多轮微调之间的效果对比难以追溯,评测制品与原始输出无法标准化持久化归档。
数据流转前序:关联训练工坊导出产物
本评测中心与网关内置的 训练数据集与模型精调工坊 深度集成。评测任务所消费的标准测试集(test.jsonl),推荐直接选取精调工坊在完成「科学采样与比例切分 (Split)」后于「成果导出 (Export)」阶段生成的产物。该测试集已经过严格的会话防交叉保护与无实体背景平衡处理,是检验微调模型泛化能力的权威基准。
2. 端到端双模型离线评测与质量把关拓扑
OmniCortex 构建了从“客观测试集接入 ➔ 双模型隔离并发推理 ➔ 全自动双盲打分与实体差分 ➔ 宏观度量大盘与样本级穿透”的端到端评测流水线:
3. 全维业务能力与治理矩阵
| 核心能力维度 | 业务应用场景 | 平台外在表现与治理价值 |
|---|---|---|
| 测试集全自动预检 | 接入第三方开源评测集或业务导出的测试集 | 自动探测并兼容多种通用结构(如实体抽取测试集、问答对话集),即时反馈有效样本量与 SHA256 指纹,彻底杜绝因格式错乱导致的无效推理。 |
| 双模型槽位对比 | 微调小模型 vs 未微调底座,或自建模型 vs 顶尖公有云模型 | 并排直观配置基准模型(Baseline)与候选模型(Candidate),支持一键克隆配置,在同一套测试样本与提示词规则下执行严格的“控制变量法”横向竞评。 |
| 细粒度推理参数隔离 | 需评估不同温度、思考链或提示词对效果的影响 | 默认采用统一控制变量模式;亦可随时开启独立模式,分别针对基准模型与微调模型定制不同的 Temperature、Max Tokens、Timeout、No-Think 开关与 System Prompt。 |
| 断点续评与增量自愈 | 上万条大规模测试集评测中途被中断或个别样本网络偶发超时 | 评测状态实时存盘并建立检查点。支持随时“暂停评测”与“断点恢复(Resume)”;对于因网络抖动偶发的失败样本,支持单键“重跑失败样本(Rerun Failed)”,无需全部从头重跑。 |
| 5 类胜负归因画像 | 快速诊断模型微调到底是提升了还是泛化退化了 | 全自动将样本划分为「改进 (Improved)」、「退化 (Regressed)」、「双方均正确」、「双方均错误」及「异常」,一键过滤退化样本,靶向攻坚微调缺陷。 |
| 样本级三栏交互 Diff | 深入微观排查模型具体把哪个实体抽错、漏抽或虚构 | 采用三栏并排卡片呈现:左栏展示真实标注彩色高亮实体,中栏与右栏分别用绿色(✓匹配)、黄色(+多标)与红色划线(-漏标)标注两模型预测差异,并支持透视原始流式输出。 |
| 分实体能力拆解矩阵 | 模型整体 F1 提升,但需排查特定类别(如地名或专有名词)是否退化 | 横向细拆并展现各类实体标签的独立精确率、召回率与 F1 变化幅度和样本分布,防止单一高频类别的提升掩盖低频关键类别的严重劣化。 |
4. 核心评测度量体系与数学口径
在离线评测体系中,系统基于样本的真实标注(Ground Truth)与两模型的预测结果,建立从实体细粒度到样本整题粒度的完整数学度量衡:
实体粒度度量(混淆矩阵)
- 真阳性 (TP, True Positive):模型预测出的实体跨度(Span)、实体类别(Label)与在文本中出现的次序(Occurrence Index)与真实标注完全匹配的实体数量;
- 假阳性 (FP, False Positive,虚报多标):模型预测出、但真实标注中并不存在的实体数量;
- 假阴性 (FN, False Negative,遗漏漏标):真实标注中存在、但模型未能成功识别出的实体数量。
基于上述混淆矩阵统计,系统精确计算三大经典度量指标:
- 精确率 (Precision, P):模型识别出的全部实体中真正正确的比例(查准率):
Precision = TP / (TP + FP) = 模型预测正确的实体数 / 模型预测出的全部实体总数 - 召回率 (Recall, R):真实标准答案包含的全部实体中被模型成功捕获的比例(查全率):
Recall = TP / (TP + FN) = 模型预测正确的实体数 / 真实标注中的全部实体总数 - 综合 F1 分数 (F1-Score):精确率与召回率的调和平均数,综合衡量模型的提取平衡能力(主锚点指标):
F1 = 2 × (Precision × Recall) / (Precision + Recall) = 2TP / (2TP + FP + FN)
样本整题粒度度量
- 完全一致率 (Exact Match Rate, EM):单条样本中,模型预测的全部实体集合与真实标注集合 100% 完全相同(且无任何多标或漏标)的样本比例。EM 是整题级别的严格满分率,直接反映模型输出的绝对稳定性;
- 格式合规率 (Format Compliance Rate):模型返回内容能够成功按照目标 JSON 格式完成结构化解析且未发生语法崩溃的样本比例,是检验轻量模型指令遵循能力的核心基线;
- 五维胜负判定规则 (Comparison Outcomes):
- 改进 (Improved):候选模型(微调后)完全一致或 F1 高于基准模型,且基准模型未答对;
- 退化 (Regressed):基准模型完全一致,而候选模型(微调后)出现答错、漏标或多标(重点警示指标);
- 双方均正确 (Both Correct):基准模型与候选模型均完全答对(Exact Match 均为 100%);
- 双方均错误 (Both Wrong):基准模型与候选模型均存在识别偏差或未答对;
- 异常 (Error):至少有一方出现模型调用超时、接口故障或返回格式破坏。
控制台配置
管理入口:系统管理 ➔ AI 工具箱 ➔ 模型微调评测 (/system/tools/model-evaluations)。
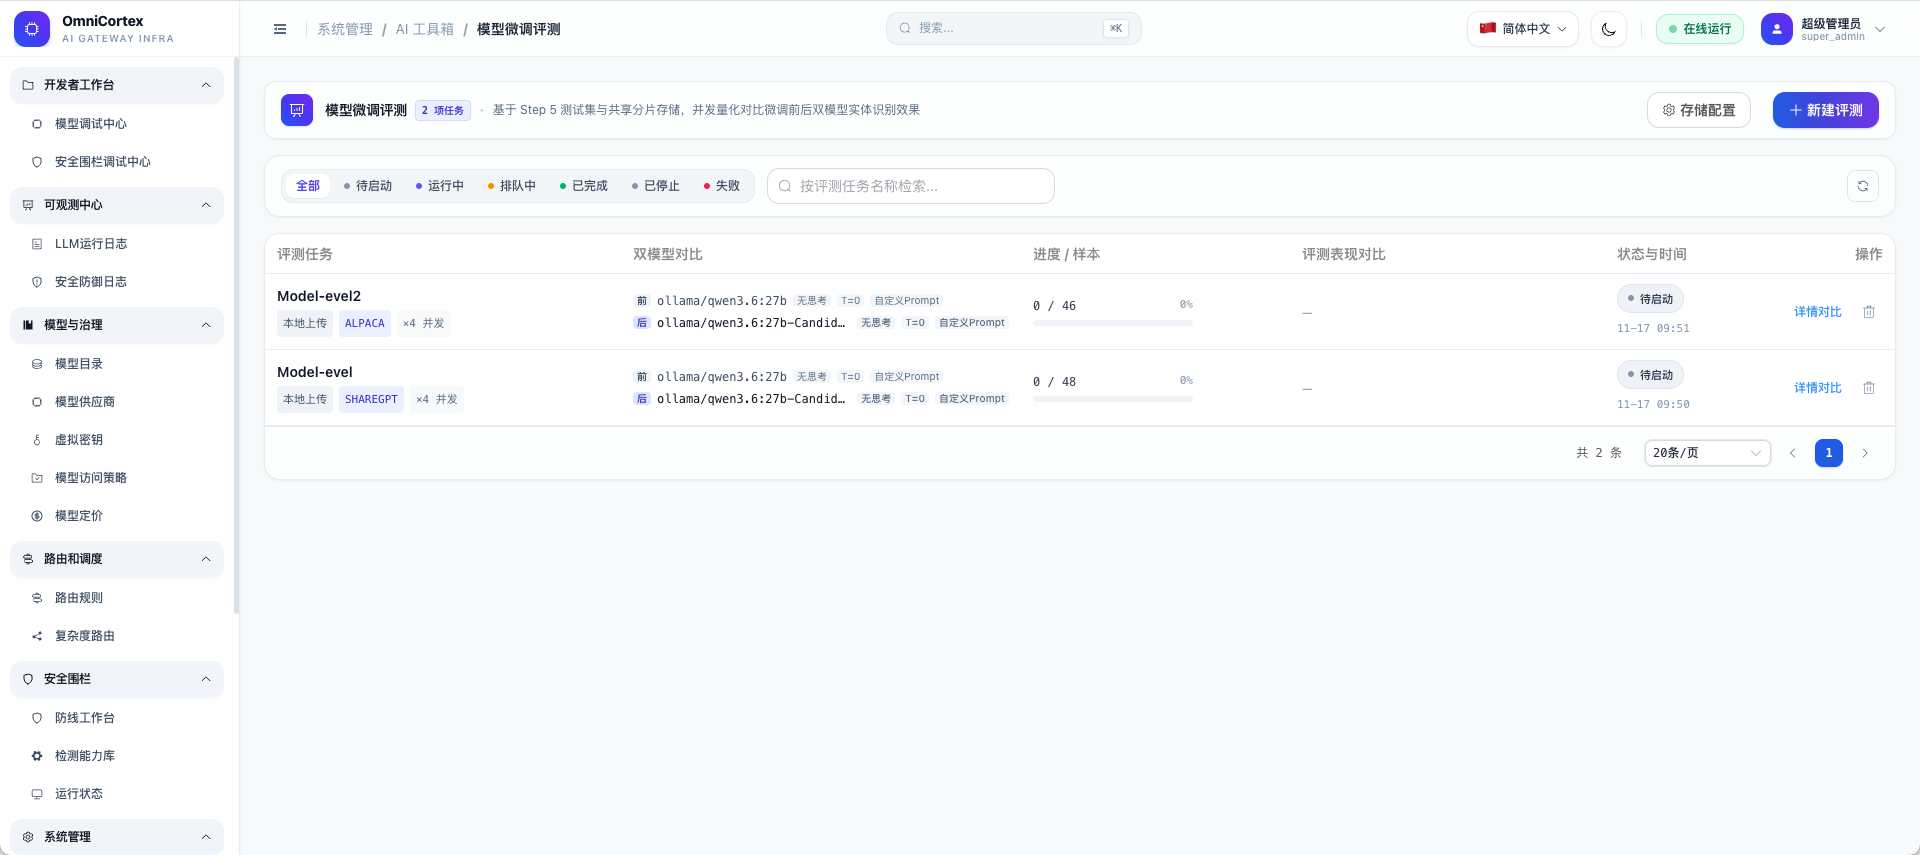
1. 评测任务大盘与全景列表
进入「模型微调评测」主界面,系统以列表形式集中展现当前纳管的全部评测任务。顶部直观提供按状态分段过滤的胶囊筛选器、即时关键字搜索栏与新建评测操作:
2. 新建双模型评测任务
点击列表右上角「新建评测」按钮,系统滑出宽屏向导抽屉(EvalCreateDrawer),按照清晰的三阶段导览完成任务配置:
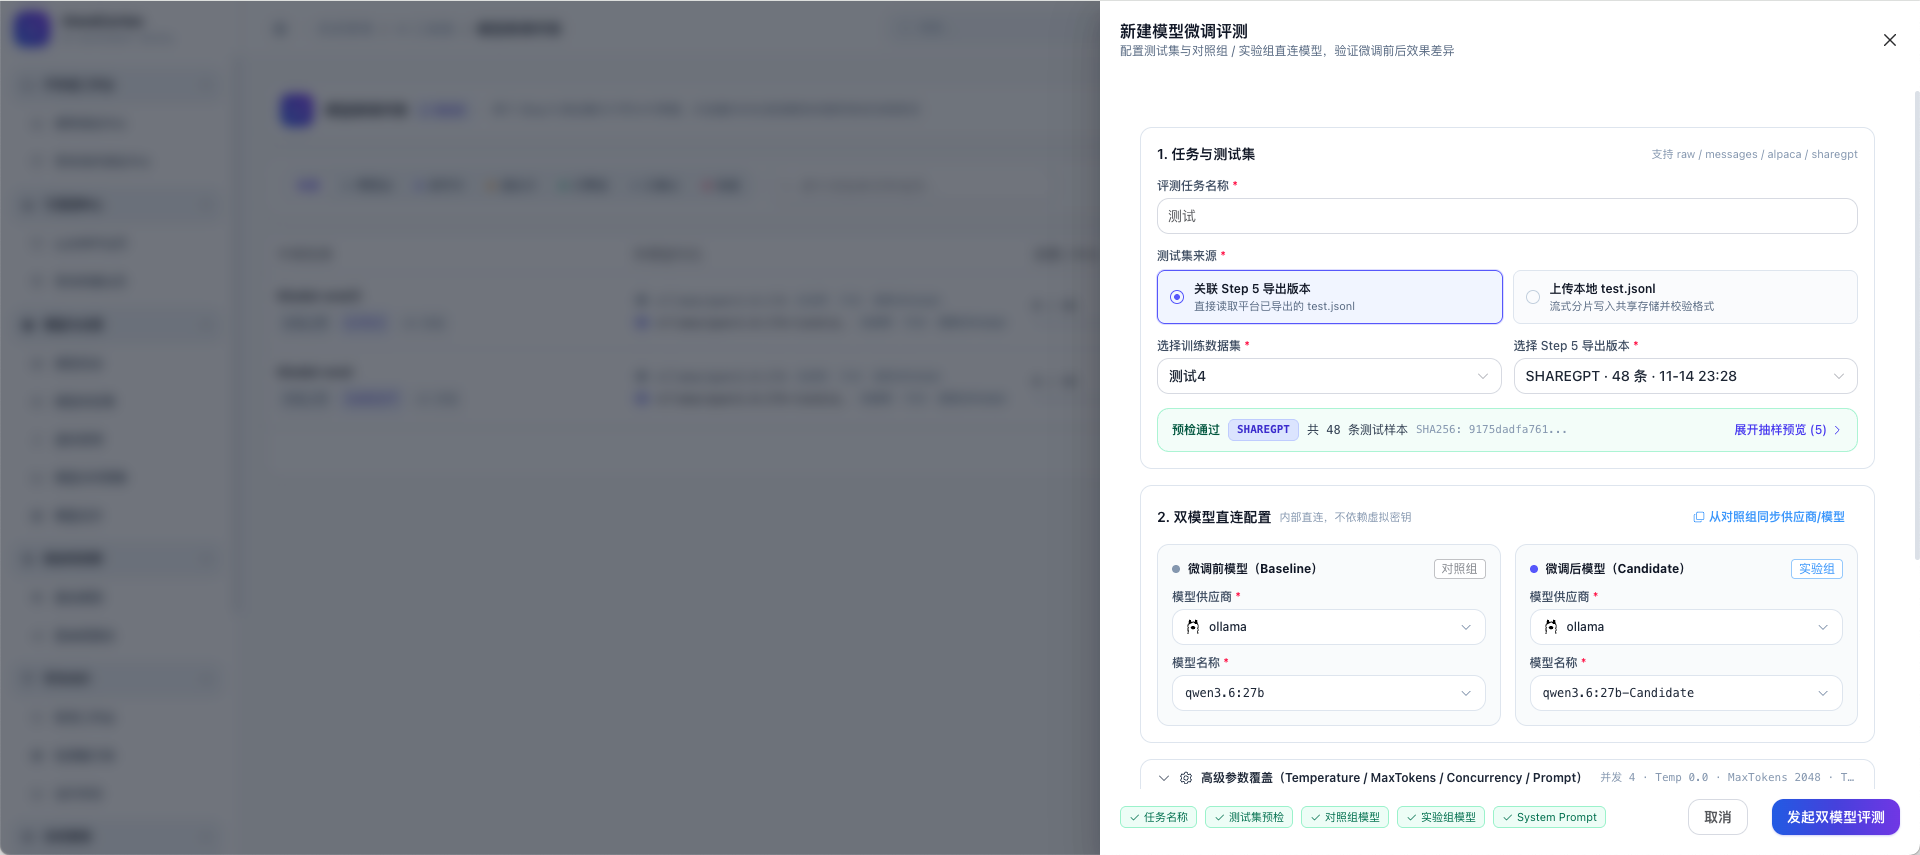
核心配置说明
- 测试集来源切换:
- 精调工坊 Step 5 导出:直接从系统内已完成「科学切分与导出」的数据集中选择对应的导出版本。系统自动识别其切分出的
test.jsonl测试集文件; - 本地测试集文件上传:支持将外部格式合规的
.jsonl文件直接拖拽上传。系统即时触发服务端预检,严格校验必填键值、计算 SHA256 签名,并抽样展示样本前瞻;
- 精调工坊 Step 5 导出:直接从系统内已完成「科学切分与导出」的数据集中选择对应的导出版本。系统自动识别其切分出的
- 双模型槽位选型:
- 基准模型槽位 (Baseline):通常配置为微调前的底座开源模型(如
qwen2.5-7b-instruct)或通识大模型; - 候选模型槽位 (Candidate):配置为已经部署并接入网关的微调专属模型;支持点击「同步基准配置」将提供商与推理参数快速复制,再行修改模型名称;
- 基准模型槽位 (Baseline):通常配置为微调前的底座开源模型(如
- 推理参数控制变量模式:
- 统一模式(默认):两模型共用同一套 Temperature、Max Tokens、Timeout 超时时间与系统抽取提示词,确保评测环境纯净无干扰;
- 独立模式(按需开启):允许针对不同模型分别设定专属 Prompt 模板或推理参数(例如针对轻量微调小模型调低上下文 Tokens,或对比不同 Prompt 引导词的效果);
- 深度思考开关 (No-Think):针对支持推理思考链(Reasoning/Thinking)的高阶模型,开启该开关可强制阻断思考流,确保直接在纯净正文层面对齐输出结果。
3. 评测详情大盘与核心指标总览
点击任意评测任务进入详情页(/system/tools/model-evaluations/:evalId)。页面顶部提供完整的执行控制动作条与动态进度条,下方聚合呈现多维度的评测指标分析大盘:
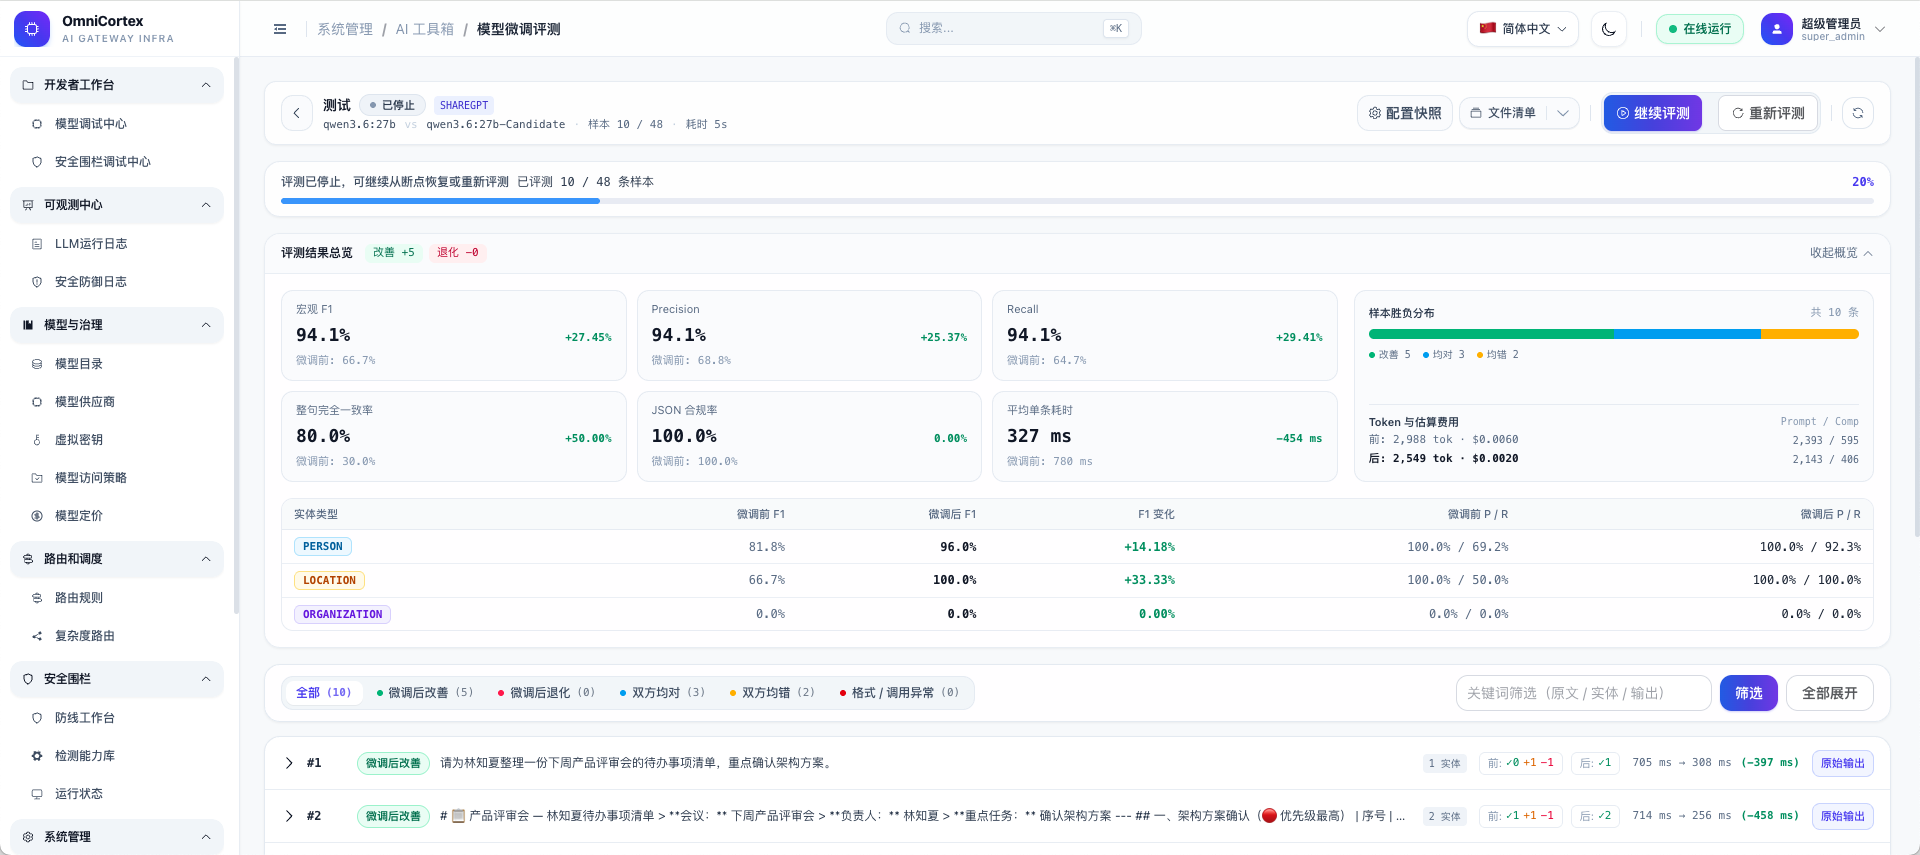
运行时控制与断点自愈
- 启动与优雅中断:新建任务进入草稿态后,点击「启动评测」即刻触发后台多协程批量推理;评测进行中,随时可点击「停止任务」触发优雅停止,系统平稳完成在途请求并记录断点;
- 断点恢复 (Resume):因维护或主动中断的任务处于「已停止」状态时,操作栏高亮呈现「恢复评测」按钮,点击后系统从最后持久化检查点继续推理,绝不浪费算力重复请求已完成样本;
- 失败重试 (Rerun Failed):若由于上游网络抖动导致个别样本产生报错(如上游 504 超时),任务终态会显示失败样本徽标,并提供「重跑失败样本」专属按钮,系统仅针对异常样本执行增量重试并自动刷新最终总览大盘。
4. 样本级三栏交互对比与实体 Diff 归因
在详情页下方,系统提供针对全量测试样本的微观审查工作台。支持通过吸顶工具栏按照胜负分类和输入关键词即时过滤,并对每条样本展开精细比对:
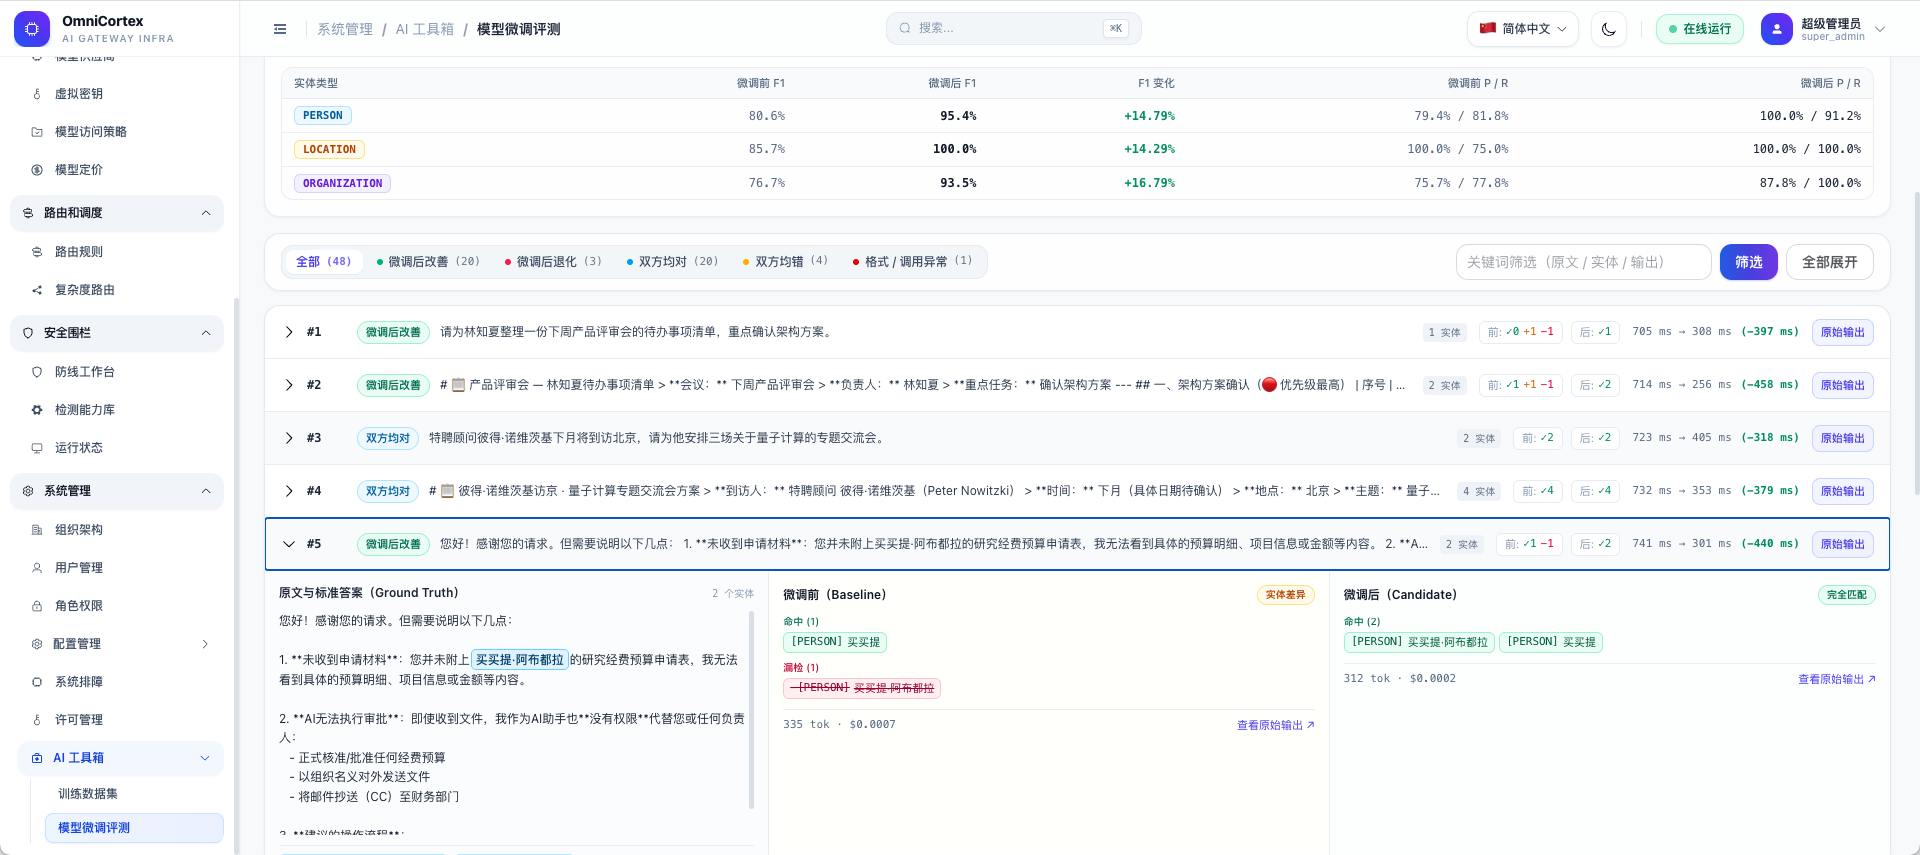
样本深度审查操作技巧
- 一键穿透退化样本:切换至「仅看退化」分类 Tab,列表将仅呈现基准模型答对但微调后模型答错的样本。算法研发人员可在此直接捕获微调导致泛化能力下降的具体成因(例如某专有名词被拆错、或由于 Prompt 变化导致格式遗漏);
- 实体差分三色标度:
- 绿色 (✓) 匹配项:模型预测与真实标注完美一致的实体;
- 黄色 (+) 多标项:模型自作聪明虚构或过度预测出的实体(导致精确率 Precision 下降);
- 红色 (-) 漏标项:模型视而不见漏掉的关键实体(导致召回率 Recall 下降);
- 原始数据无缝透视:点击样本卡右上角「原始输出」,系统滑出代码高亮抽屉,可直接查验模型未经清洗的完整响应体,排查特殊字符转义、JSON 解析异常或模型拒绝回答等深层问题。