智能语义分析与模型复杂度路由
复杂度路由(Complexity Router)用来判断用户请求属于 SIMPLE、MEDIUM 还是 COMPLEX,并将结果写入路由规则引擎的 complexity_tier 变量。配合 路由规则,业务方只需要请求同一个逻辑模型名,就能让日常简单问答直接走轻量快速模型、复杂推理任务自动走主力推理模型,不需要在业务代码里写死正则或维护多套调用入口。
工作方式
1. 按需触发,不影响常规路由
复杂度路由与路由规则解耦:
- 当启用的路由规则中没有引用
complexity_tier,或者前置条件已经为假(例如model == "copilot" && complexity_tier == "SIMPLE"中传入的不是"copilot")时,网关通过 CEL 局部求值直接跳过,不会调用 Embedding 或决策模型; - 只有规则的最终结果确实取决于
complexity_tier时,才会执行一次复杂度分类,且同一条请求的链式规则流转期间最多只计算一次。
2. 两种分类模式
控制台支持在语义向量模式和决策模型模式之间切换:
| 模式 | 判定原理 | 适用场景 |
|---|---|---|
语义向量模式 (semantic) | 把各层级参考短语预先向量化。请求到达时计算用户输入向量的余弦相似度,高于阈值 min_similarity 时直接归入最相似短语所属层级。 | 有明确高频句式、对分类延迟敏感、需要通过增删短语精确控制边界的场景。 |
决策模型模式 (decision) | 把对话上下文连同三个层级的定义(Definition)、特征信号(Signals)和代表用例(Examples)发给专用决策模型,由模型直接输出分级结果。 | 长尾复杂意图多、同义改写丰富、或需要结合多轮上下文语义综合判断的场景。 |
语义未命中降级:在语义向量模式下,如果输入与所有参考短语的最高相似度都低于 min_similarity,可以配置三种后续动作:
- 不降级 (
none):本次请求不产生complexity_tier(规则中依赖该字段的条件不会匹配,按默认路由继续); - 决策模型 (
decision):转由决策模型按各层级标准判定; - LLM 分类器 (
llm):转由通用对话模型按自定义分类提示词判定(网关会自动附加 JSON 响应格式约束)。
3. 会话粘性路由(24 小时单调保持)
开启会话粘性路由后,网关会按请求的 Session ID(例如请求头 x-session-id)记录该会话已达到过的最高复杂度层级(空闲窗口 24 小时,TTL 24h):
- 只升不降:会话一旦进入
COMPLEX,后续轮次即使只发了一句简短指令(如“继续”、“改一下第二点”)或进入工具调用续接(Tool Continuation),依然保持在COMPLEX,避免模型中途切回轻量模型打断上下文质量; - 更高难度可继续拉升:从
SIMPLE起步的会话在遇到复杂提问时可上升至MEDIUM或COMPLEX; - 无 Session ID:不启用粘性记忆,每次请求独立分类。
x-session-id,先查询 24h 窗口内已记录的层级;若已处于 COMPLEX 或属于工具调用续接,直接复用 COMPLEX(mechanism = session)。 min_similarity 直接命中;低于阈值则触发 none / decision / llm 降级策略。 Definition / Signals / Examples 发往决策模型,在超时预算内返回层级。 max(当前判定层级, 会话历史层级) 写入 complexity_tier,交由路由规则匹配具体目标模型。 三级复杂度划分参考
| 复杂度层级 | 典型任务类型 | 示例输入 | 常见目标模型定位 |
|---|---|---|---|
SIMPLE | 问候寒暄、单轮事实查询、简短翻译或格式整理 | “在 Go 语言里怎么把字符串转成整型?” | 响应快、无前置长思考链的轻量模型(如 gpt-4o-mini、deepseek-chat) |
MEDIUM | 文档摘要、会议纪要提取、常规代码编写、结构化改写 | “如何在大表中添加可空列并在线回填历史数据?” | 兼顾理解力与响应速度的通用主力模型(如 gpt-4o) |
COMPLEX | 多步推理、架构设计权衡、复杂排错与算法实现 | “为 API 网关和数据库制定多活容灾与故障转移方案,并对比权衡。” | 推理能力更强的旗舰或思考模型(如 deepseek-reasoner、o1) |
控制台配置说明
管理入口:路由和调度 ➔ 复杂度路由 (/routing/complexity-router)。
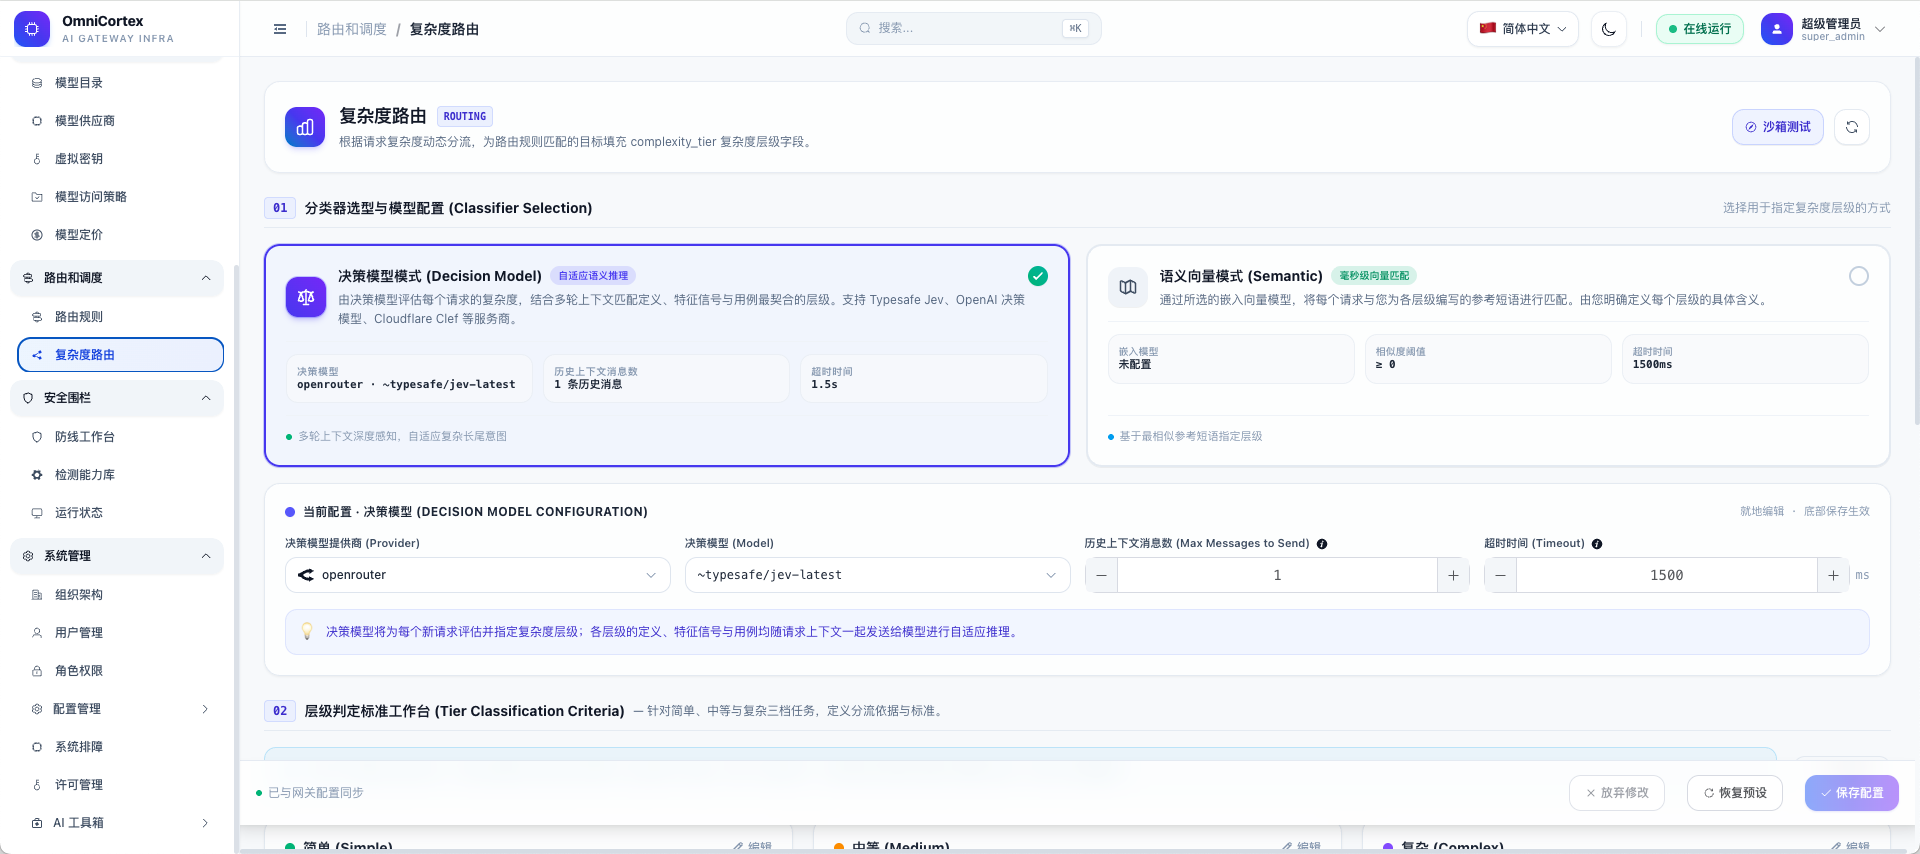
配置页面由上到下分为三个阶段:01 分类器选型与模型配置、02 层级判定标准工作台、03 流向与降级策略,修改后在页面底部统一保存生效。
1. 主界面、增量预热与权限提示
- 分类器运行状态:语义模式下,顶部状态栏会实时显示
已就绪、预热中、预热失败、未配置等状态。修改参考短语后点击保存,系统仅对新增或修改的短语执行增量向量化,已有短语向量直接复用;预热期间上一版索引继续在线服务,不影响既有流量。 - 阶段 02 判定基准:
- 语义向量模式:分三列维护 Simple / Medium / Complex 参考短语,支持逗号或换行批量输入;平台所有层级合计上限为 750 条短语,单条最长 2000 字符。
- 决策模型模式:分三列维护每个层级的定义(Definition)、特征信号(Signals,最多 12 条)与代表用例(Examples,最多 12 条)。系统预置了一套默认基准,建议按业务语言习惯补充具体任务示例。
- 阶段 03 降级与会话粘性:配置语义未命中降级策略,以及 24 小时会话粘性路由开关。
- 授权状态:若顶部出现未授权警告横幅,说明当前许可未包含
complexity_router权益,配置编辑与沙箱测试会处于只读禁用状态,需在「系统管理 ➔ 许可管理」(/system/license) 中导入对应许可。
2. 分类器驱动参数说明
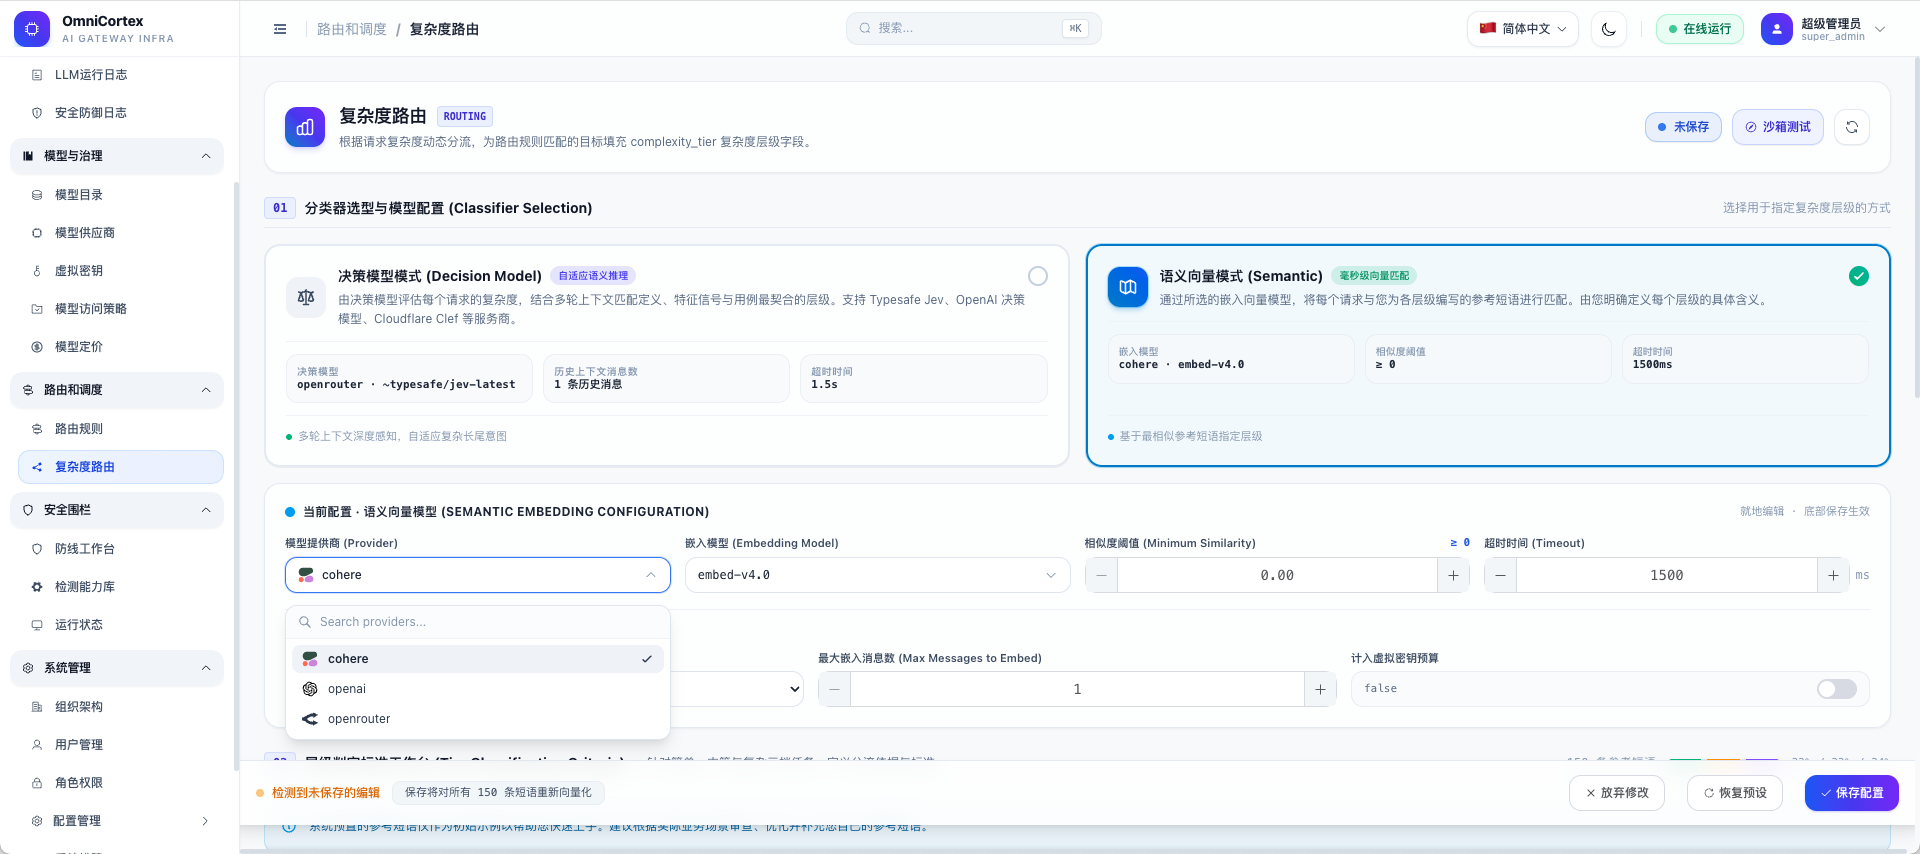
语义向量模式参数:
- 模型提供商与嵌入模型:下拉仅列出支持 Embedding 接口的供应商(如 OpenAI、Azure、Cohere、Gemini、Ollama、vLLM 等),凭据复用供应商管理中的配置。
- 相似度阈值 (
min_similarity):判定命中的最低余弦相似度(范围0 ~ 0.99,默认建议设置在0.70 ~ 0.80之间)。设得过高容易大量触发降级,设得过低则容易误归类。 - 超时时间 (
timeout):单次计算输入向量的最大等待时间(默认1500ms),超时则按未命中处理或跳过复杂度路由。 - 存储介质 (
vector_store):内置内存存储 (embedded)常驻网关进程内存,无需外部依赖;外部向量数据库 (vector_store)适用于已接入外部向量库的集中式存储场景。 - 最大嵌入消息数 (
message_history_count):在当前消息之外向前合并嵌入的用户消息数(1 ~ 10条,默认1)。 - 计入虚拟密钥预算 (
count_toward_budgets):开启后,分类阶段调用 Embedding 或 LLM 产生的用量会记入对应虚拟密钥的周期配额中。
决策模型模式参数:
- 决策模型:支持专职决策模型(默认
typesafe / jev-latest,OpenRouter 下为~typesafe/jev-latest)、OpenAIgpt-6-luna、Perplexitypplx-decider-v1.1-27b、Cloudflare@cf/cloudflare/clef-flash,以及私有化部署的 Laya、Nimble、Clef。其中 Laya 每次请求读取上限为512 tokens(长文本或多语言场景建议选用支持1024 tokens的多语言模型)。 - 历史上下文消息数 (
previous_message_count):除当前请求外额外附带的历史用户消息数(0 ~ 5条,默认1;只发送用户消息,不发送助手历史回复)。 - 分类超时时间 (
timeout):默认1500ms,超时后会跳过复杂度分类并按未配置复杂度条件处理。
3. 沙箱测试诊断
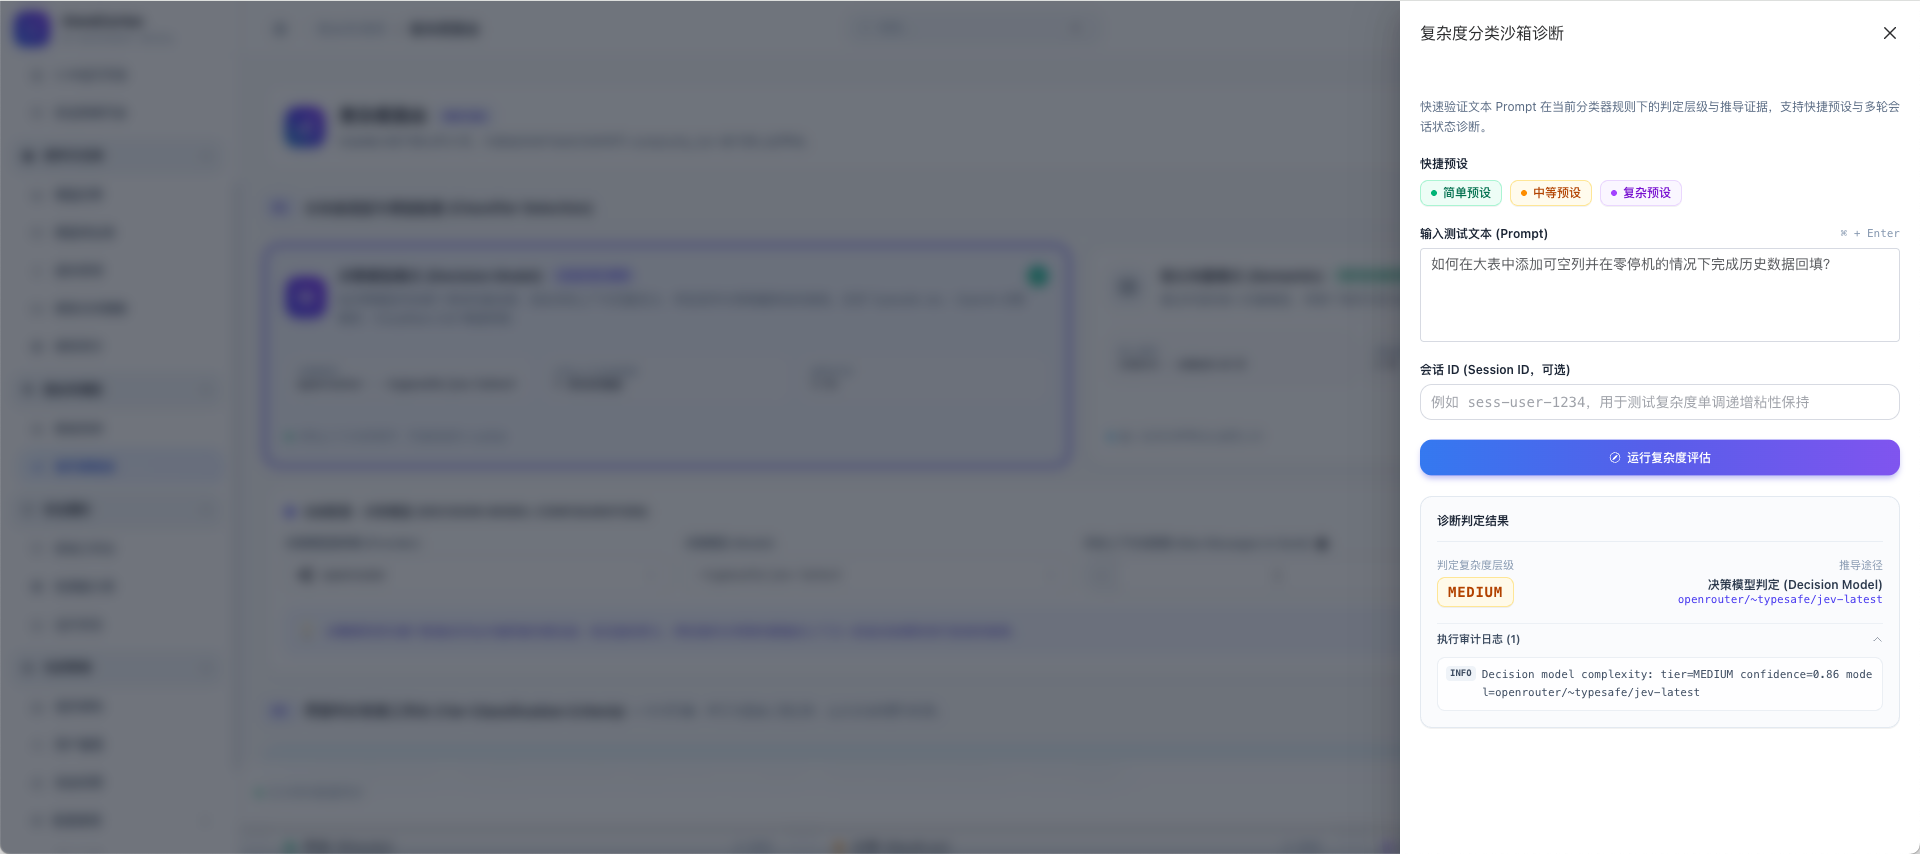
点击右上角沙箱测试,可以在不影响线上配置的前提下测试任意文本的判定结果。抽屉内提供简单、中等、复杂三档快捷测试文本(快捷键 ⌘ + Enter / Ctrl + Enter 运行),并支持填写可选的 Session ID 连续发送多条测试以验证 24 小时单调粘性效果。判定结果区会直接展示归属层级、推导途径、驱动模型、最高相似度分值、命中的最接近参考短语以及完整执行日志。
与路由规则联动及日志观测
1. CEL 规则写法
复杂度路由本身不直接转发请求,而是向 路由规则 的 CEL 引擎提供 complexity_tier 变量(字符串类型,取值为 "SIMPLE"、"MEDIUM" 或 "COMPLEX"):
// 规则 1(Priority: 90):简单请求直接走轻量模型
model == "enterprise-copilot" && complexity_tier == "SIMPLE"
➔ Targets: openai / gpt-4o-mini (weight: 1.0)

// 规则 2(Priority: 85):中等或复杂请求走推理模型,并配置兜底
model == "enterprise-copilot" && complexity_tier in ["MEDIUM", "COMPLEX"]
➔ Targets: deepseek / deepseek-reasoner (weight: 1.0)
➔ Fallbacks: [{"provider": "openai", "model": "gpt-4o"}]
NOTE
CEL 表达式中仅提供 complexity_tier 这一个复杂度变量。分类途径(complexity_mechanism)与相似度分值仅用于仿真与日志审计,不能写入 CEL 条件,否则会在保存时触发 undeclared reference 编译错误。
2. 日志中的判定字段说明
在「可观测中心 ➔ LLM运行日志」(/observability/llm-logs) 的路由追踪视图中,可以查看命中复杂度规则的请求是如何被判定的。其中 complexity_mechanism 的取值含义如下:
| 取值 | 含义 |
|---|---|
semantic | 由语义向量相似度匹配直接得出 |
decision | 由决策模型得出(主分类器或语义未命中降级) |
llm | 由降级 LLM 分类器得出 |
session | 命中 24h 会话粘性或工具续接,继承会话历史最高层级 |
skipped | 规则要求评估复杂度,但因无有效文本、分析器未启用、超时或未命中且降级设为 none 而跳过 |
常见异常与故障排查
| 现象 / 提示 | 原因 | 处理方式 |
|---|---|---|
状态长期停留在 预热中 或提示 预热失败 | 配置的 Embedding 供应商 API Key 无效、模型不可用、触发限流或网络不通。 | 检查该供应商在「模型供应商」中的凭证和模型配置,修复后点击状态栏旁的「重试预热」。 |
| 语义模式频繁未命中 / 全部走降级 | min_similarity 设得过高,或参考短语库与实际业务提问句式差异较大。 | 将 min_similarity 调整到 0.70 ~ 0.80 区间,并用沙箱测试检查实际相似度分值,按业务真实问法补充参考短语。 |
| 决策模型分类超时 | 选用的模型响应慢于 timeout 设定,或误选了响应较长的通用推理模型。 | 优先使用专职决策模型(如 jev-latest、Laya、Nimble、Clef),或将超时时间从 1500ms 适当放宽。 |
| 多轮对话中途掉回低复杂度模型 | 未开启「会话粘性路由」,或客户端请求未携带统一的 Session ID。 | 确认阶段 03 已启用会话粘性路由,并在同一会话的连续请求头中传入一致的 x-session-id。 |
顶部出现 功能未授权 横幅 | 当前许可未开通 complexity_router 特性权限。 | 在「系统管理 ➔ 许可管理」(/system/license) 中核对并导入包含复杂度路由权益的许可。 |