大模型实体识别引擎 (llm_ner)
大模型实体识别引擎(llm_ner)是 OmniCortex 安全围栏体系中针对非结构化自然语言实体的高级语义识别与防护驱动。
传统正则(regex)和模式匹配仅适用于具备固定格式的数据(如身份证号、手机号、银行卡号)。而在自由文本对话中,人名、地名、企业机构名称形式多样,没有固定的格式规律,静态规则极易漏报或误报;传统基于统计的自然语言处理(NLP)模型对中文多义词(如“祝你平安”与“我叫平安”)也容易产生误判,且需要独立维护算法服务。
llm_ner 直接复用网关接入的大语言模型(可选用商用轻量模型,也可以是企业私有化部署、经过微调的高性能自建小模型)作为判决中枢,在用户提示词发送给业务模型前,精准识别并定位人名(PERSON)、地名(LOCATION)与机构名(ORGANIZATION),并根据业务策略执行原位脱敏、拦截阻断或安全审计。
一、 运行形态与部署依赖
| 评估维度 | 特性表现 |
|---|---|
| 运行形态 | 网关内部调度,复用网关核心已接入的模型资源执行检测,在请求流转中自动完成,无需客户端额外适配。 |
| 外部部署依赖 | 零外部独立服务依赖,无需在内网额外搭建专用的 NLP 微服务集群,简化运维与系统架构。 |
| 凭据与资源复用 | 复用网关既有算力,直接使用网关已配置的模型供应商与模型(支持公有云商用模型或本地私有算力池),无需为安全引擎单独申请或分配凭据。 |
| 调用隔离机制 | 内部独立通道调度,安全检测在网关内部独立运行,不占用业务外部调用配额,杜绝循环调用。 |
| 用量与费用透视 | 主请求透明计费,判决产生的 Token 消耗与模型调用费用记录在请求审计日志中,便于统一追踪与核算。 |
大模型实体识别与原位决策流水线
[PERSON]、[LOCATION]),脱敏后的内容正常流转至业务模型。二、 能力边界与处置动作
1. 防护阶段与检测范围
- 输入侧前置防护:在用户提示词发送给业务模型前完成实体识别与清洗,从源头确保敏感实体不流入外部模型;
- 增量会话精准检测:在多轮对话中精准对用户最新发言执行敏感实体检测,确保上下文处理高效顺畅。
2. 支持的处置动作矩阵
| 处置动作 | 支持情况 | 动作生效表现与业务影响 |
|---|---|---|
刚性阻断 (block) | ✅ 支持 | 命中阻断规则后立即终止请求,向客户端返回安全拦截提示,阻止内容发送至下游模型。 |
动态脱敏 (redact) | ✅ 支持 | 将识别出的实体文字就地替换为规范掩码占位符(如 [PERSON]、[LOCATION]),下游业务模型接收已脱敏文本并正常回答。 |
仅检测审计 (detect_only) | ✅ 支持 | 旁路观察模式,不对输入做任何改写或拦截,在全链路安全审计日志中记录实体发现详情,用于流量摸底与规则调优。 |
三、 典型业务应用场景
- 场景一:自然人姓名识别与脱敏 用户在智能客服、政务热线或内部问答中常提及具体人员(如“请问欧阳建国工程师今天是否在岗”、“咨询李阿姨的复查安排”)。普通规则无法穷举中文姓名且容易与日常用语混淆,
大模型实体识别引擎凭借上下文语义理解能力,可准确识别真实人名并就地替换为[PERSON]掩码。 - 场景二:收货地址与企业厂区定位防外泄 售后派单、物流调度或工单跟进中涉及口语化或复合地名(如“请派人前往上海市浦东新区张江高科集电港二期大厦东门”)。
builtin:llm_ner:location能够识别包含园区、道路、楼栋的完整地址信息,前置执行脱敏或阻断,避免企业物理位置数据流入外部模型。 - 场景三:涉密机构与关键合作方名称拦截 员工在向外部大模型提问时,无意中输入包含关键合作单位或涉密客户的名称(如“关于星海联合商业银行股份有限公司与华东云计算安全研究院的备忘录”)。管理员可通过将
builtin:llm_ner:organization设为block,在请求流出企业网关前直接拦截。 - 场景四:编程代码与系统标识符防误判放行 在辅助编程与代码问答场景中,代码中常包含类似
PersonServiceImpl、LocationManager等包含实体词根的函数名与类名。大模型实体识别引擎内置了编程标识符排他准则,避免误伤开发者的正常代码开发与调试请求。
四、 规则体系与识别指引
1. 开箱即用规则库
系统内置 3 条只读实体规则,属于命名实体(pii.entity)分类:
规则标识 (rule_id) | 实体类型 | 默认风险级别 | 默认脱敏掩码 | 识别目标说明 |
|---|---|---|---|---|
builtin:llm_ner:person | PERSON | 中危 (Medium) | [PERSON] | 识别提示词中的真实自然人姓名与称谓 |
builtin:llm_ner:location | LOCATION | 中危 (Medium) | [LOCATION] | 识别具体地理位置、行政区划、街道门牌与建筑物名称 |
builtin:llm_ner:organization | ORGANIZATION | 中危 (Medium) | [ORGANIZATION] | 识别具体公司企业、金融机构、政府部门与社会团体名称 |
NOTE
大模型实体识别引擎 引擎依托大语言模型的语义理解能力进行实体抽取与研判。如需扩展特定实体的识别边界或适配专有模型,可通过控制台的「自定义系统提示词」进行灵活配置。
2. 实体识别与交互约定
裁判模型按照约定的格式返回提取出的敏感实体信息:
- 检出实体:返回包含实体类型(人名、地名或机构名)与原文文本的结构化结果;
- 未检出实体:返回空结果,网关直接放行;
- 防幻觉与防漂移保护:系统内置输出格式校验,自动过滤模型返回中多余的自然语言说明,确保识别结果稳定可靠;
- 语义上下文精准定位:面对一词多义(如一句话中同时出现日常祝愿词“平安”与人名“平安”),系统结合上下文语义,仅对真正构成敏感实体的词汇进行定位与打码,保留合法的日常表达。
3. 自定义系统提示词
网关内置了经过验证的默认识别指引,明确了人名、地名、机构的判定边界与排他原则。
管理员可在控制台配置「自定义系统提示词」,用于替换默认指引:
- 适配自建微调模型:若企业内部针对专有业务训练了专用的微调实体抽取模型(可使用网关内置的 训练数据集与模型精调工坊 提取生产日志并导出微调集),可在此填入微调时使用的抽取指令;
- 定义行业特殊规则:可在此明确特定行业称谓、保密项目的判定偏好。
协同联动:私有微调小模型训练指引
llm_ner 预设的人名(PERSON)、地名(LOCATION)与机构名(ORGANIZATION)三大实体,与网关内置的 训练数据集与模型精调工坊 规则定义完全一致。企业可直接在工坊中从生产日志中抽取语料、完成智能打标与人工复核,微调出 0.5B ~ 7B 的专属轻量 NER 判决模型并接入网关,实现在企业局域网内极速、低时延地完成敏感数据识别与原位脱敏。
五、 关键配置项说明
管理员在配置 llm_ner 引擎驱动时,可在控制台设置以下参数:
| 配置项 | 参数类型 | 默认值 | 允许取值范围 | 业务含义与配置建议 |
|---|---|---|---|---|
裁判供应商 (provider) | 字符串 | 必填 | 网关已注册供应商 | 执行实体识别的裁判大模型供应商(如 openai、azure、qwen 等)。 |
裁判模型 (model) | 字符串 | 必填 | 有效模型标识或别名 | 执行实体识别的具体模型标识或别名。可选用商用轻量模型(如 gpt-4o-mini、qwen2.5-7b),也可以是企业私有化部署、经过微调的高性能自建小模型(具备更低的网络延迟与更确定的抽取表现)。 |
自定义系统提示词 (system_prompt) | 字符串 | 默认内置指引 | 最大 8192 字节 | 自定义任务指令覆盖内容。省略时使用内置默认提示词;配置时不可为空白字符。 |
检测超时时限 (timeout_ms) | 整数 (ms) | 5000 | 100 ~ 30000 | 引擎单次执行内部判决的总超时上限。 |
最大输入长度 (max_input_bytes) | 整数 (字节) | 16384 (16 KiB) | 1 ~ 65536 | 待检查文本的累计最大输入字节数,超出时前置拒绝,防止超大文本耗尽判决算力。 |
单次最大受检项 (max_items) | 整数 (个) | 16 | 1 ~ 32 | 单次检查允许的最大受检项数量。 |
最大内部调用次数 (max_model_calls) | 整数 (次) | 16 | 1 ~ 32 | 单个逻辑业务请求中该引擎允许发起的最大内部模型调用次数。 |
最大生成 Token (max_output_tokens) | 整数 (Token) | 2048 | 128 ~ 8192 | 内部模型调用的输出 Token 上限,防止模型输出失控。 |
最大返回长度 (max_response_bytes) | 整数 (字节) | 65536 (64 KiB) | 1024 ~ 262144 | 模型返回内容解析前的最大允许字节长度。 |
最大检出实体数 (max_findings) | 整数 (个) | 128 | 1 ~ 512 | 单次检查允许发现的最大实体数量上限,超出时自动触发保护。 |
六、 企业控制台配置与沙盒实操
管理入口:安全围栏 ➔ 检测能力库 (/security/guardrails/capabilities) ➔ 驱动引擎列表。
1. 引擎基础配置与连通性检查
在检测能力库左侧驱动列表中选中 llm_ner 驱动,进入配置面板:
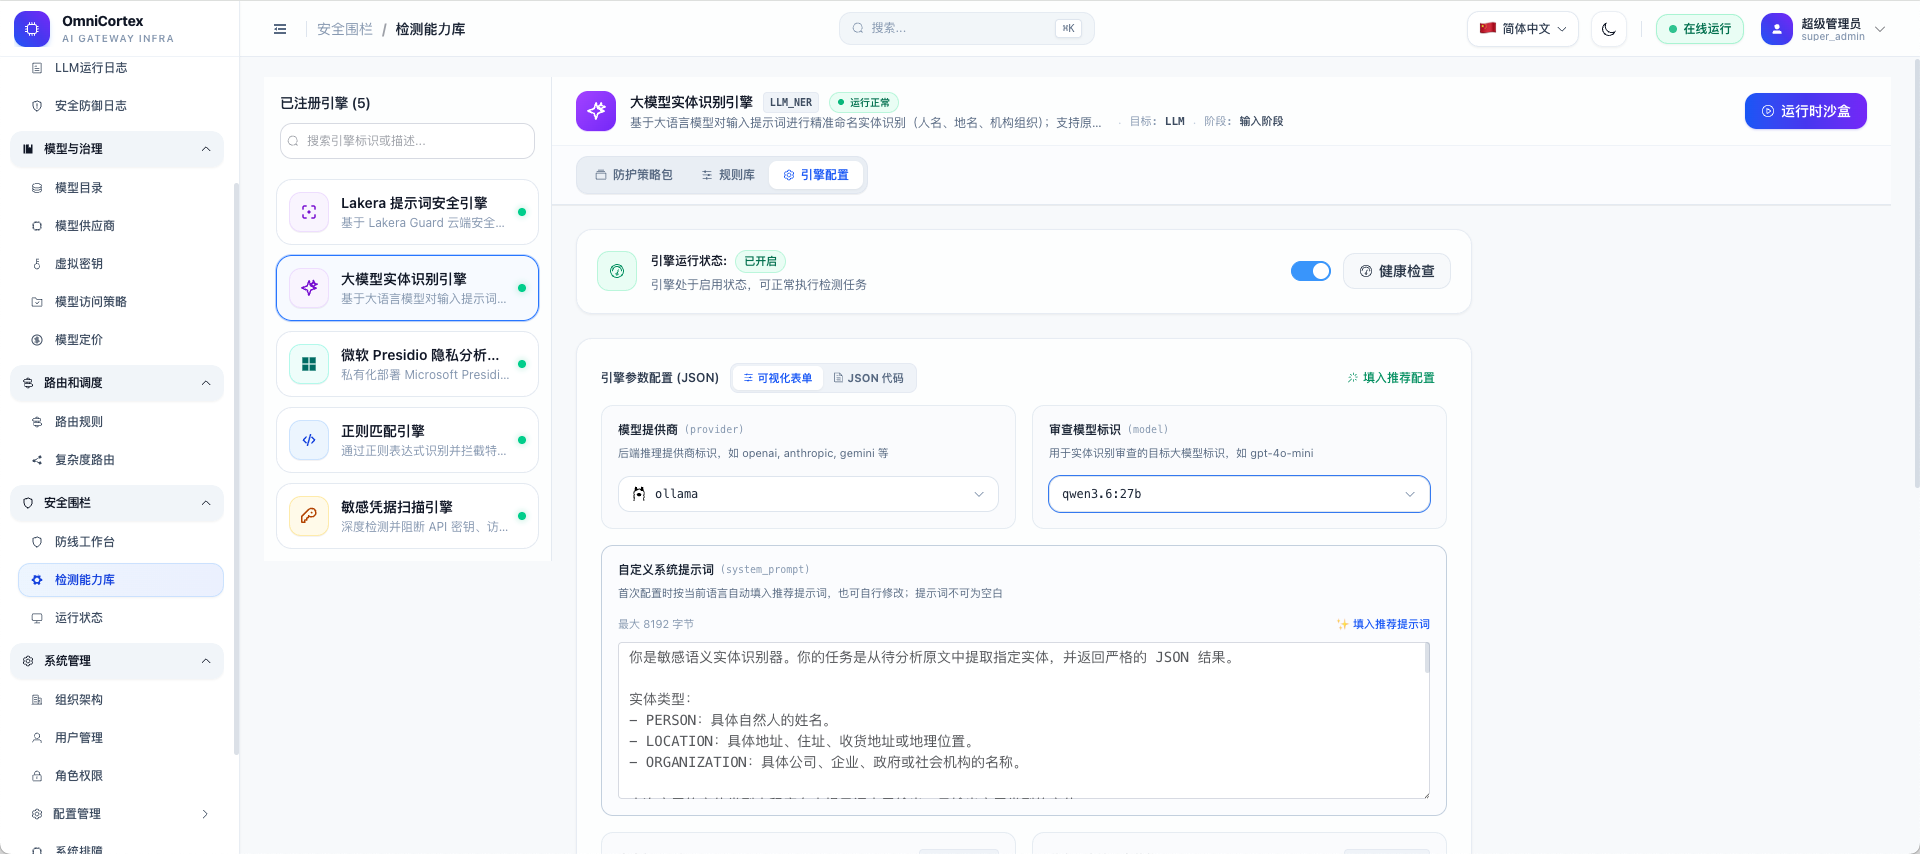
- 必填项验证:保存配置时,系统自动对
provider与model进行非空验证,未填写时前端拦截保存; - 健康检查:点击「连通性检查」按钮,网关在本地核验 Provider 与 Model 的有效性,不发起远端付费模型调用。
2. 运行时沙盒即时诊断与用量费用透视
点击「调试沙盒」按钮滑出沙盒抽屉(EngineSandboxDrawer),可在真实规则下进行样本测试:
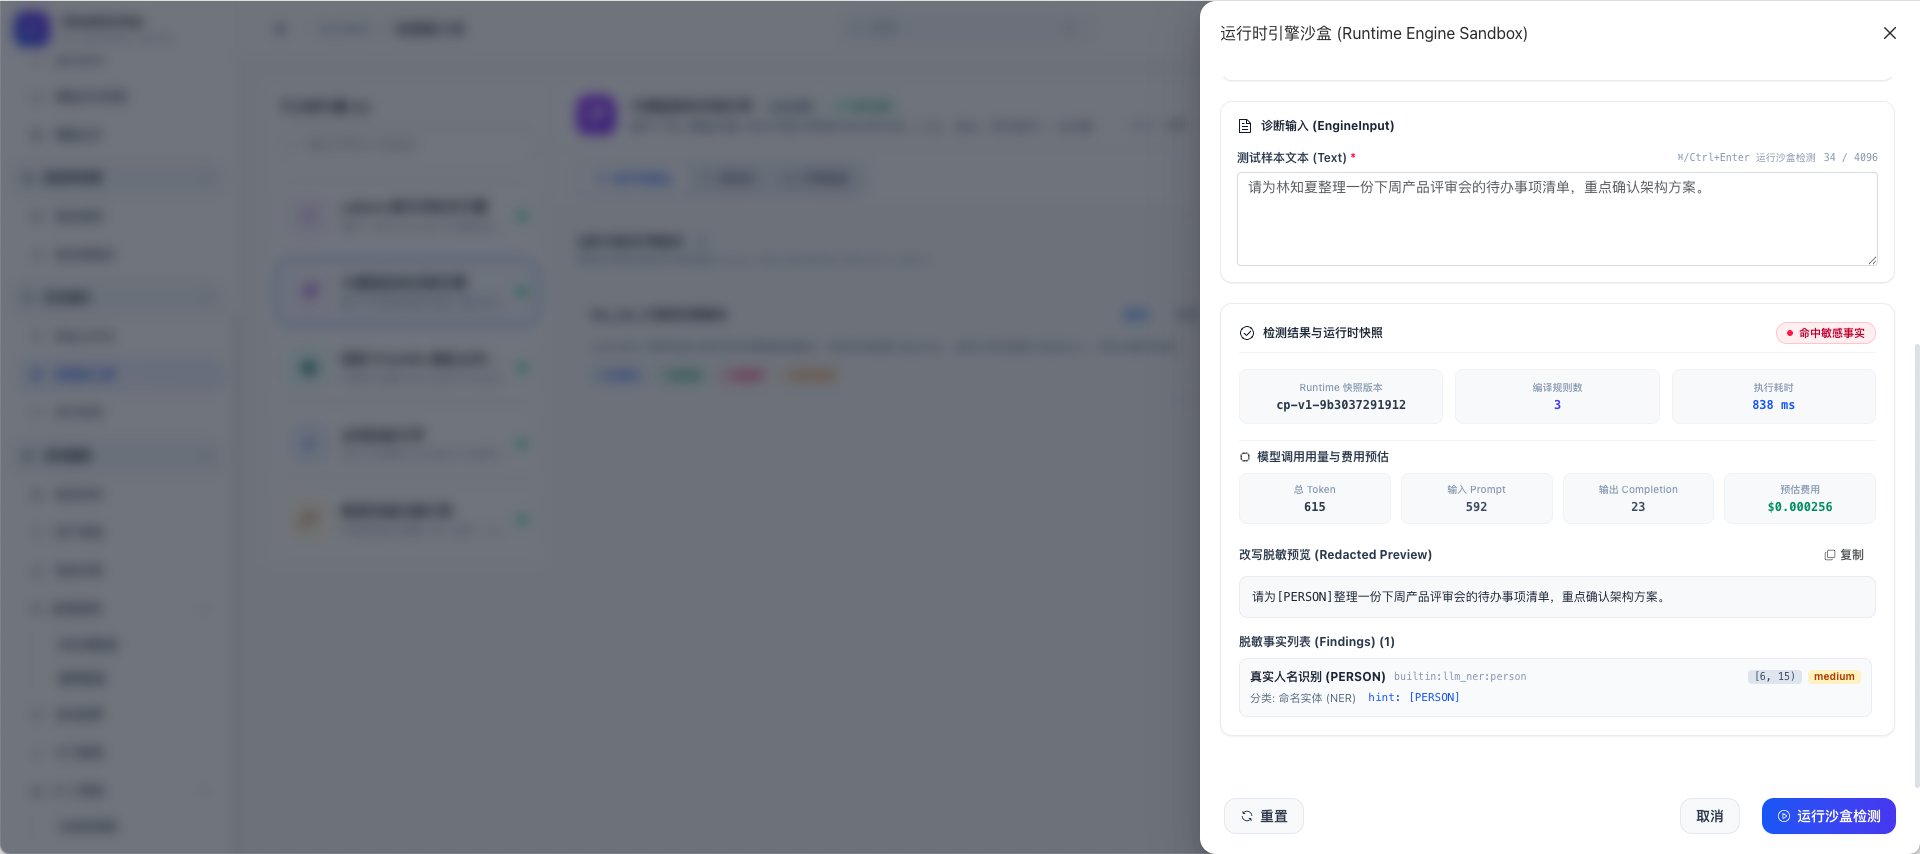
- 真实调用提示:沙盒顶部包含提示横幅,提示本次测试会发起实际模型调用并消耗 Token;
- 用量与费用核算:测试完成后,结果卡片展示检测调用的 Token 消耗与根据模型价格计算出的附加费用;
- 测试样本获取:如需现成的脱敏测试语料,可前往 训练数据集工坊 使用内置工具一键注入 120 条包含人名、地名与机构名的模拟聊天样本并复制使用。
七、 业务场景与多引擎协同建议
1. 核心适用场景
- 非结构化自然语言实体抽取:从口语化会话、工单咨询或日常提问中提取中文人名、非标准地名及复杂机构组织;
- 长篇叙事中的实体识别:对嵌套在长文本、复合语句中的专有名词,静态规则难以穷举,利用大模型的上下文理解能力精准识别;
- 灵活的差异化处置策略:配合安全策略包,实现细粒度的策略编排——例如对自然人姓名执行原位脱敏(
redact)、对涉密机构执行直接阻断(block)、对一般地名执行旁路审计(detect_only)。
2. 纵深防御编排最佳实践
在安全围栏防线工作台(Workbench)中编排流水线时,推荐将 llm_ner 与其他专用安全引擎协同组合,构建层次分明的纵深防御体系:
客户端输入 Prompt
  │
  ├─► 第一道防线 [特征与合规过滤]: regex / secrets 引擎 (快速匹配身份证、手机号、API 密钥等固定模式凭据)
  │
  ├─► 第二道防线 [安全对抗仲裁]: lakera_guard 引擎 (实时拦截越狱攻击与 Prompt 注入)
  │
  └─► 第三道防线 [语义实体识别]: llm_ner 引擎 (深度识别口语化文本中的人名、地址与机构,执行精准脱敏或拦截)
        │
        ▼ (清洗后的合规安全上下文)
  投递至目标业务大模型
通过多引擎分工协作,既能确保固定模式敏感数据的高效过滤与越狱防护,又能充分发挥大模型在复杂非结构化语言理解上的深度识别优势。
八、 常见异常与排查建议
| 异常现象 / 提示 | 常见原因 | 建议排查与处理方式 |
|---|---|---|
| 模型未配置或未生效 | 引擎配置中指定的供应商或模型在网关中不存在,或处于禁用状态。 | 检查「算力资产」中的供应商与模型列表,确认模型标识拼写正确且凭据状态正常。 |
| 模型返回格式不符合预期 | 裁判模型未按照要求输出结构化结果,包含了多余的自然语言说明。 | 1. 选用遵循能力更强的模型(如商用轻量模型或经过微调的高性能自建小模型); 2. 检查自定义系统提示词,确保未修改核心输出要求。 |
| 实体在原文中未匹配到对应位置 | 模型识别出的实体文字在用户输入的原文中不存在(模型可能产生了拼写幻觉)。 | 1. 检查输入文本中是否包含非常规特殊字符; 2. 若模型频繁出现幻觉,建议更换理解能力更强或经过微调的裁判模型。 |
| 输入文本超出长度上限 | 用户输入的提示词长度超过了配置的「最大输入长度」(默认 16384 字节)。 | 如业务确有长文本需求,在引擎配置中适当调高「最大输入长度」参数。 |
| 检测超时 | 内部模型在设定的超时时限内未完成响应。 | 1. 检查所选模型的网络延迟与上游响应速度; 2. 适当调大超时时限,或选用部署在本地内网的高性能自建微调小模型。 |
| 检出实体数量超限 | 单次检测出的实体数量超过了设定的最大上限(默认 128 个)。 | 检查是否存在异常的大批量文本灌入;如为正常业务场景,可在配置中调大最大实体数量。 |