动态条件路由与流量策略编排
动态条件路由(Routing Rules)用于在网关层按请求特征动态决定上游供应商、目标模型、物理 API Key 以及容灾降级链路。规则基于 Google CEL(Common Expression Language)编写并预编译缓存,业务客户端继续使用标准接口和统一模型名发起请求,灰度切流、超限溢出、旧别名迁移和流式首字超时切换都在网关侧完成。
核心机制
1. 匹配优先级与 First-Match-Wins
网关按组织层级从细到粗依次查找规则,在同一层级内按 priority 升序评估(0 优先级最高,同一生效范围下 priority 不可重复):
- 虚拟密钥 (
virtual_key) - 个人成员 (
user) - 部门团队 (
team) - 客户主体 (
customer)(兼容既有历史配置) - 全局兜底 (
global)
默认情况下采用 First-Match-Wins:命中第一条满足条件的规则后立即生成路由决策并停止后续匹配;如果该规则开启了 chain_rule,则进入链式二次评估。
2. CEL 表达式与上下文变量
规则创建或更新时会进行 CEL 语法与变量校验,运行期直接执行预编译字节码。当前路由引擎支持以下上下文变量:
| 变量名 | 类型 | 说明与示例 |
|---|---|---|
model | string | 请求传入的模型名,如 model == "enterprise-copilot" |
provider | string | 解析出的供应商标识,如 provider == "openai" |
request_type | string | 请求接口类型,流式与非流式独立区分,如 chat_completion、chat_completion_stream、responses、responses_stream、embedding、image_generation |
headers | map<string, string> | 请求头(键名大小写归一化,建议统一小写),如 headers["x-env"] == "canary" |
params | map<string, string> | URL 查询参数,如 params["region"] == "cn" |
virtual_key_id / virtual_key_name | string | 鉴权虚拟密钥的 ID 与名称 |
user_id | string | 归属用户 ID |
team_id / team_name | string | 归属团队 ID 与名称 |
customer_id / customer_name | string | 归属客户 ID 与名称 |
tokens_used | double | 当前 Token 限流配额使用率百分比(0.0 ~ 100.0+) |
request | double | 当前请求次数限流配额使用率百分比(0.0 ~ 100.0+) |
budget_used | double | 当前周期用量配额使用率百分比(0.0 ~ 100.0+) |
complexity_tier | string | 请求文本复杂度等级:"SIMPLE"、"MEDIUM" 或 "COMPLEX" |
使用 CEL 条件时的几个关键行为:
- 缺失的 Header / Query 参数:当
headers["x-tier"]或params["..."]在请求中不存在时,对应判断静默求值为false(不会抛出运行时错误)。 - 流式请求类型需显式区分:
chat_completion仅匹配非流式对话,覆盖流式对话需使用request_type in ["chat_completion", "chat_completion_stream"]。 - 复杂度变量懒求值(Partial Evaluation):引擎会先把
complexity_tier标记为未知量做局部求值。例如model == "copilot" && complexity_tier == "SIMPLE",当请求模型不是"copilot"时直接判定为不匹配,不会触发复杂度分析;只有前置条件成立、结果真正依赖complexity_tier时,才会执行一次分类,且整个链式评估周期内最多计算一次。
3. 加权目标、链式规则与流式 TTFT 熔断
- 加权目标与 Key Pinning:单条规则可配置多个目标(
provider+model),所有目标的weight之和必须等于1.0(100%)。每个目标都可以单独绑定物理key_id,跳过供应商默认 Key 池轮询,直接走指定凭据。 - 链式规则 (
chain_rule):开启chain_rule: true后,命中的目标provider与model会写回上下文,从最高优先级作用域重新开始新一轮评估,同时刷新新目标对应的tokens_used、request和budget_used。同一条规则在单次请求的链式流转中不会重复触发;当命中chain_rule: false的终端规则、无规则匹配、候选链式规则全部已执行过,或达到最大链式深度(默认10层)时停止。 - Fallback 降级与流式 TTFT 超时截断:
fallbacks支持对象格式(指定provider、model与可选的key_id),在主目标返回上游错误或不可用时按顺序尝试。- 每个目标可独立设置
ttft_timeout_ms(仅对流式请求生效)。若上游在规定时间内未返回首个有效输出分块,网关断开当前连接并切换至下一条 Fallback;Fallback 链的最后一个保底目标不会触发 TTFT 截断,避免彻底放弃等待。
model、provider、request_type、headers、params 与用量百分比,生成遍历顺序:virtual_key ➔ user ➔ team ➔ customer ➔ global。 complexity_tier 时才触发复杂度计算;命中首条规则后按目标权重随机选路(可选锁定 key_id)。 ttft_timeout_ms),按序切往 fallbacks 链(末位目标免疫 TTFT 截断)。 provider/model 写回上下文并刷新限流/用量水位,回到第 2 步从头匹配下一阶段规则。 典型配置示例
以下示例覆盖生产中高频使用的几种路由编排方式,所有参数均可直接在控制台表单中配置。
1. 模型灰度分流与流式 TTFT 兜底
将逻辑模型 customer-service-bot 的流量按 80% / 20% 分流到两个模型;对灰度通道设置 3000ms 流式首字超时,超时或报错时自动切回稳定模型:
- CEL 条件:
model == "customer-service-bot" - 目标 (
targets):openai / gpt-4o(weight: 0.8)deepseek / deepseek-chat(weight: 0.2,ttft_timeout_ms: 3000)
- 降级 (
fallbacks):[{"provider": "openai", "model": "gpt-4o"}]
2. 按请求复杂度分级调度
业务端只调用统一模型名 enterprise-copilot,网关按 complexity_tier 把简单问答与复杂推理分流到不同模型(分类规则的配置见 复杂度路由):
- 规则 A(Priority
90):model == "enterprise-copilot" && complexity_tier == "SIMPLE"➔openai / gpt-4o-mini - 规则 B(Priority
85):model == "enterprise-copilot" && complexity_tier in ["MEDIUM", "COMPLEX"]➔deepseek / deepseek-reasoner,Fallback:[{"provider": "openai", "model": "gpt-4o"}]
3. 限流 / 用量高水位自动溢出
当主模型或供应商的 Token 限流或周期用量使用率达到 80% 时,把新请求提前导向备用通道,避免主通道直接触发 429:
- CEL 条件:
model == "gpt-4o" && (tokens_used >= 80.0 || budget_used >= 80.0) - Priority:
20(高于常规默认规则) - 目标 (
targets):azure / gpt-4o(weight: 1.0)
4. 旧模型别名清洗 + 下游链式分流
存量调用方仍传入已下线的模型名(如 gpt-3.5-turbo),先用一条高优先级链式规则将其归一化为标准逻辑别名,再复用下游已有的灰度或复杂度规则,无需为每个旧模型复制整套配置:
- 阶段 1(Priority
10,开启chain_rule: true):- 条件:
model in ["gpt-3.5-turbo", "text-davinci-003"] - 目标:
model = "enterprise-copilot"
- 条件:
- 阶段 2(Priority
85/90,chain_rule: false):- 请求以
enterprise-copilot重新进入作用域链,直接命中示例 2 的分流规则。
- 请求以
5. 多级 Fallback 级联容灾
为关键业务指定多层降级顺序,并在主目标及中间降级通道上启用 TTFT 保护:
- CEL 条件:
model == "deepseek-reasoner" - 目标 (
targets):deepseek / deepseek-reasoner(weight: 1.0,ttft_timeout_ms: 3000) - 降级 (
fallbacks):{"provider": "deepseek", "model": "deepseek-chat"}{"provider": "openai", "model": "gpt-4o"}
控制台操作说明
管理入口:路由和调度 ➔ 路由规则 (/routing/rules)。
1. 规则列表与配额状态
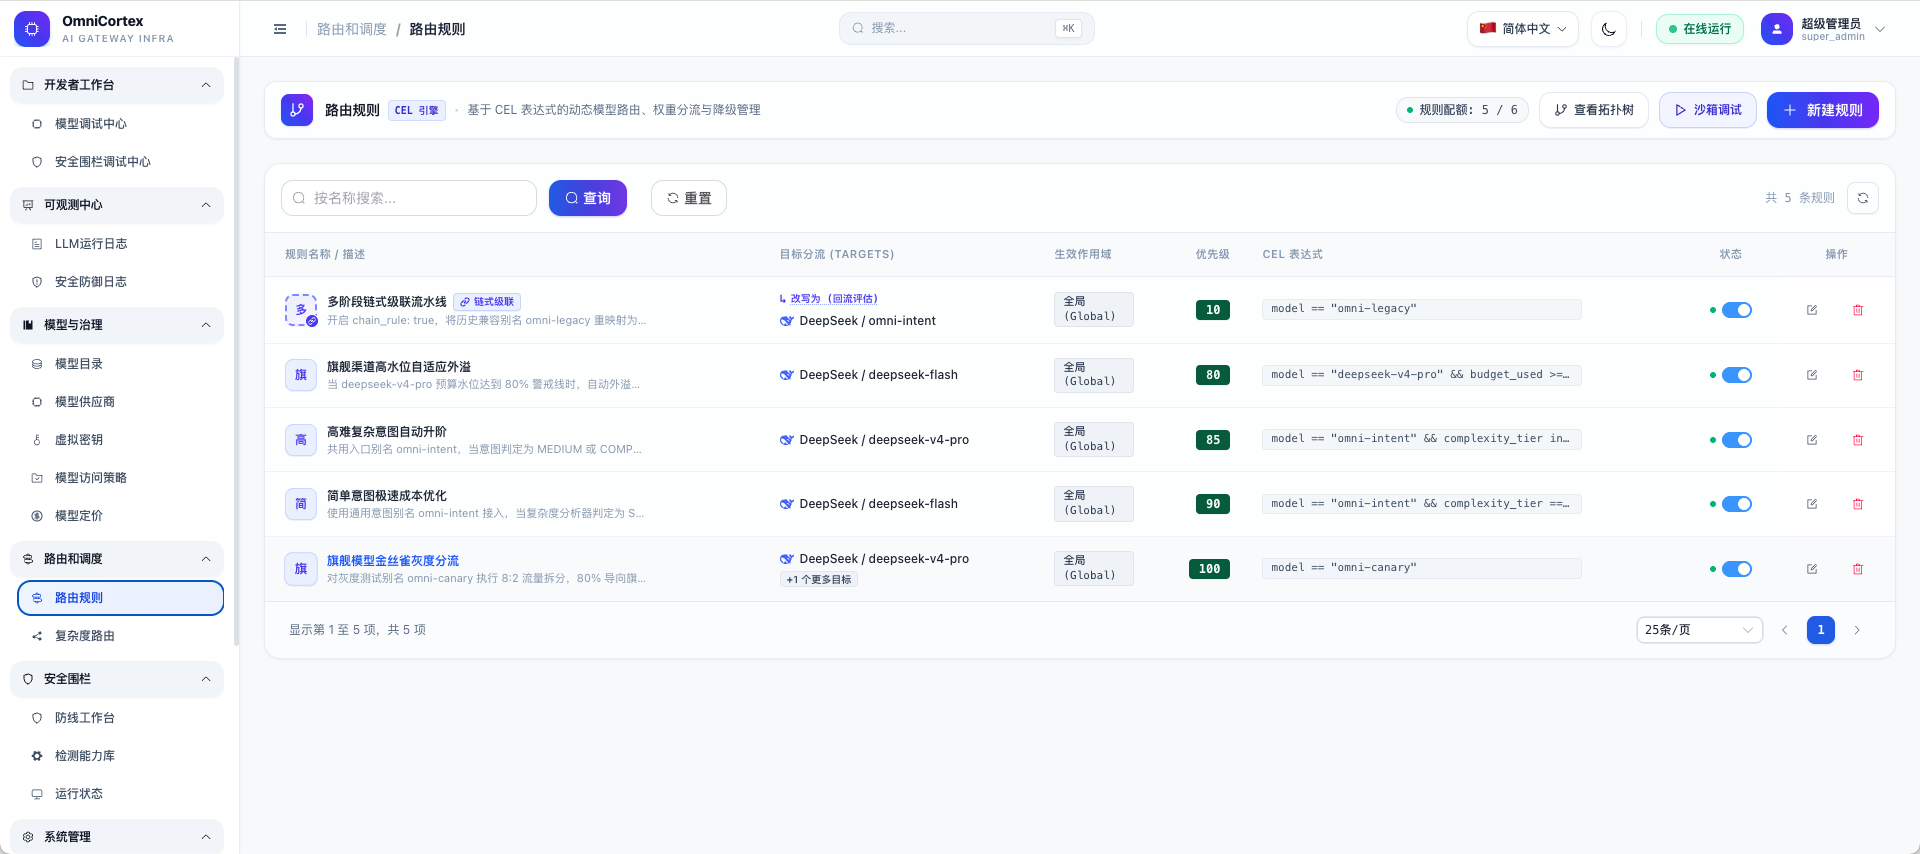
顶部状态栏展示当前实例的规则配额使用情况(规则配额: 已用 / 上限),以及查看拓扑树、沙箱调试和新建规则入口。主表格支持按规则名称检索,并在列表中直接展示链式标记、目标分流权重(多目标时通过 +N 悬浮查看全部)、生效作用域、优先级、CEL 表达式及启用开关。
2. 路由决策拓扑树
点击顶部的查看拓扑树可切换至 /routing/rules/tree,以左右流向图查看当前全部启用规则的生效关系:左侧为请求生效作用域,中间为规则节点(含优先级和链式标记),右侧为解析出的目标模型、分流权重与 TTFT 超时配置。
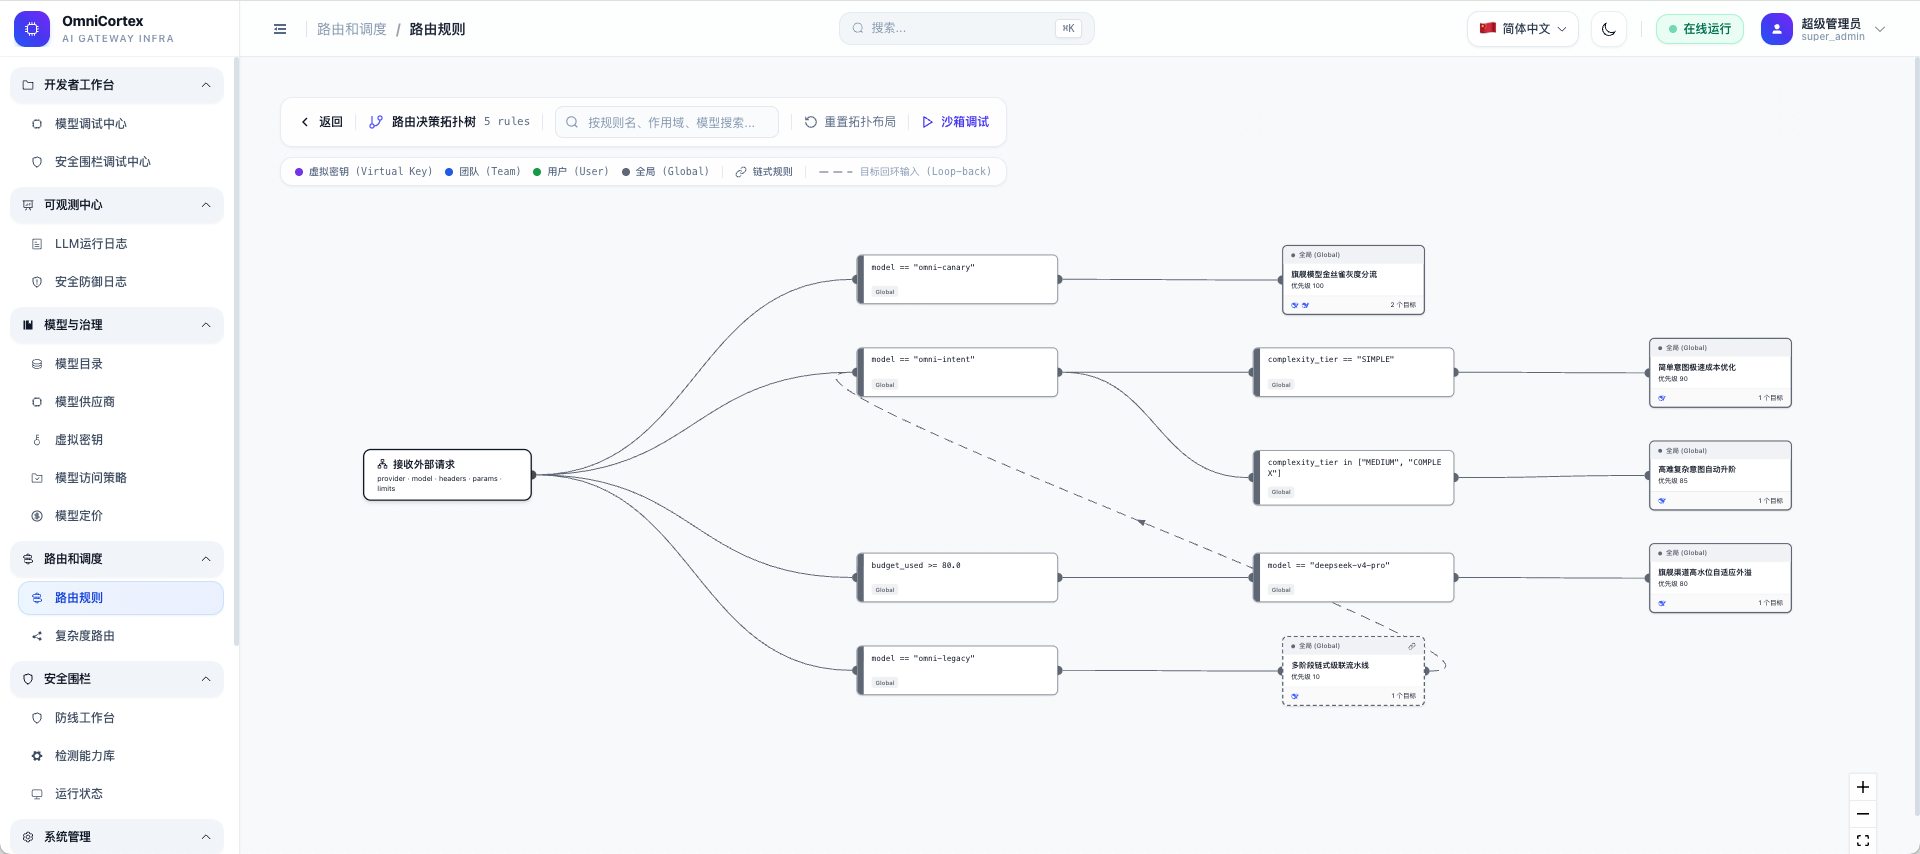
拖拽节点调整排版后会自动保存在浏览器本地;点击任意规则节点可高亮其上下游依赖,适合在规则较多时排查链式规则是否有冗余或循环引用。
3. 新建与编辑规则
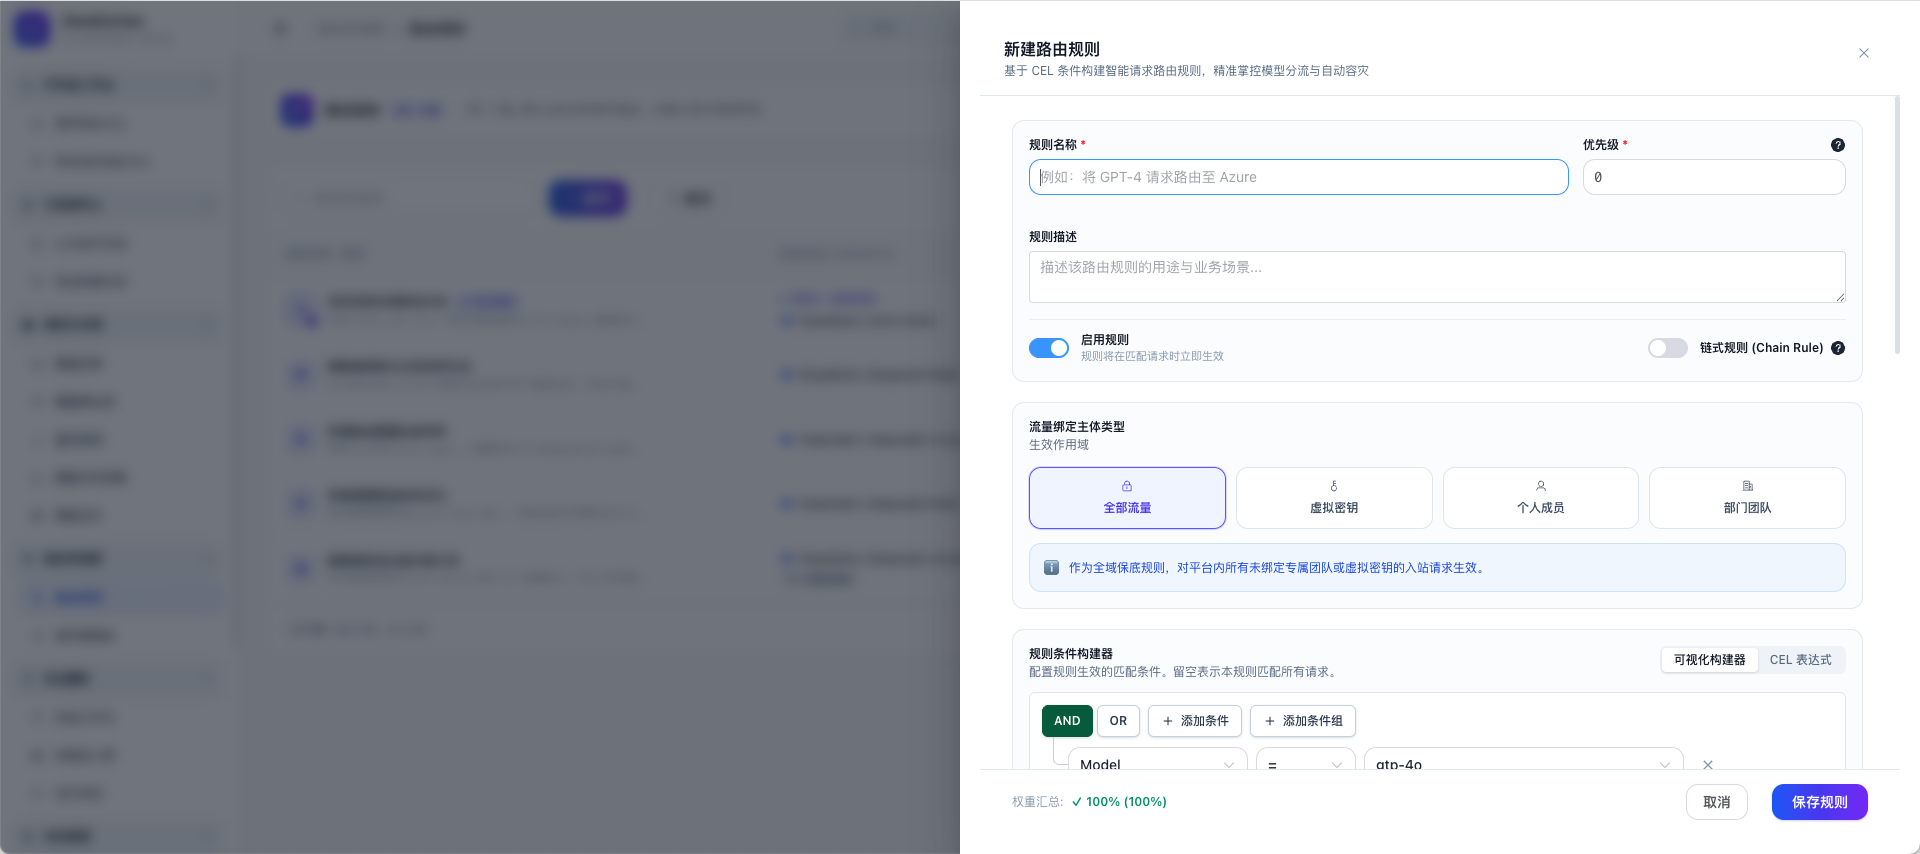
点击新建规则打开配置抽屉,表单按以下五个区域组织:
- 基础信息:填写规则名称、优先级(
0 ~ 1000,数字越小越先匹配)、描述,以及启用规则和链式规则 (Chain Rule) 开关。 - 流量绑定主体:在「全部流量」、「虚拟密钥」、「个人成员」、「部门团队」四项中选择生效范围;选定非全局范围后需指定具体目标(部门支持树形级联选择)。
- 匹配条件 (CEL):支持可视化条件分组(AND/OR 嵌套、字段下拉、运算符和值选择),也可随时切换到手动模式直接编辑原生 CEL 表达式,保存时校验语法。
- 目标分流 (Targets):增减转发目标并分配权重,抽屉底部会实时校验所有目标权重之和是否严格等于
100%;需要固定走某张上游凭证时,可在目标行绑定专属物理 Key。 - 降级链条与 TTFT 超时:按回退顺序列出 Fallback 目标;流式 TTFT 超时提供
2s、3s (推荐)、5s和关闭 (Off)快捷预设,也可直接输入毫秒数(范围1 ~ 60000)。未配置规则级 Fallback 时,表单会提示 TTFT 超时仅在请求自身携带降级参数时才会触发切换。
💡 配置建议
- 优先级预留步长:同作用域内优先级必须唯一,建议按
10、20、30间隔递增,方便后续插入紧急覆盖规则。 - 链式规则避免自环:启用
chain_rule时,确保改写后的上下文最终能命中chain_rule: false的规则或正常落空,否则最多跑满 10 层后强行终止。 - 思考模型的 TTFT 阈值:DeepSeek-R1 等推理模型有时首包等待较久,TTFT 设得过短(如
2000ms)容易误切 Fallback,建议根据上游实际首字耗时设在3000ms ~ 5000ms或按目标单独关闭。
4. 沙箱调试与真实请求验证
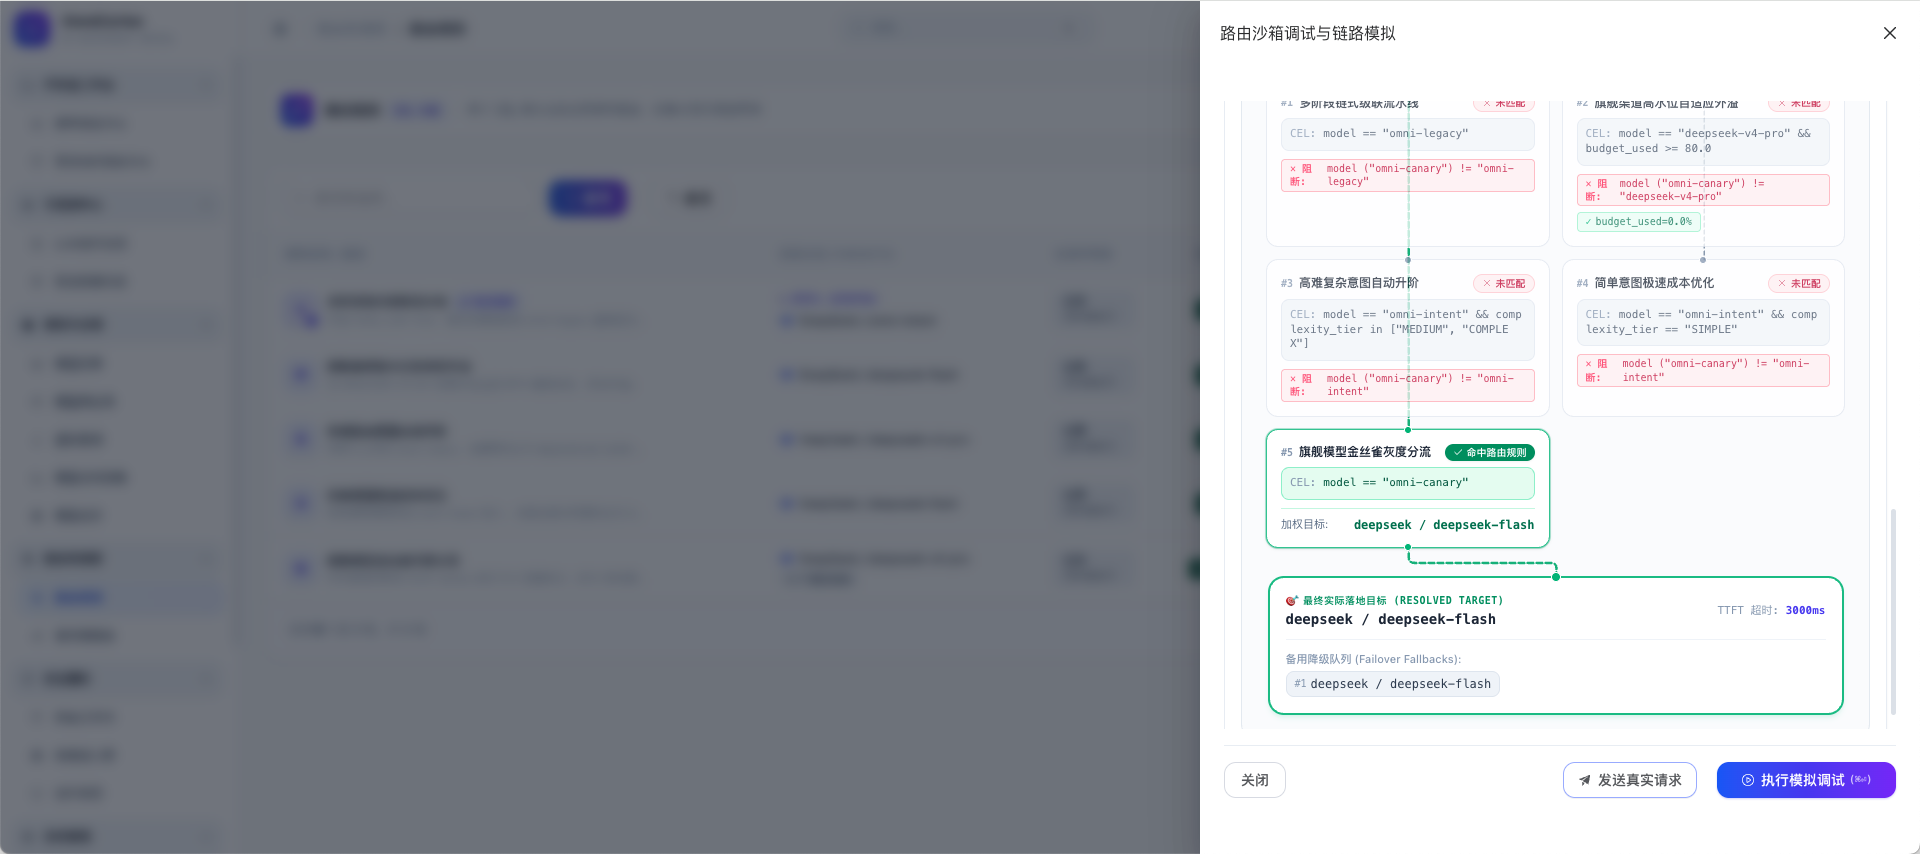
在规则上线前,可通过右上角的沙箱调试在内存中模拟规则评估,无需向真实上游发包:
- 填入虚拟密钥、请求模型(或直接点击规则模型快捷胶囊)、请求类型与自定义请求头;若规则涉及
complexity_tier,可展开高级上下文填入对话消息或使用内置SIMPLE/MEDIUM/COMPLEX预设文本。 - 运行后右侧展示命中规则、最终解析的 Provider/Model、Fallback 队列,以及决策树拓扑图 (DAG) 与原始逐级日志(每条作用域和规则为何命中或跳过)。
- 确认规则路径无误后,点击底部的发送真实请求可直接携带当前参数向网关发起真实流式调用,验证端到端响应与最终落盘日志。
在调用日志中排查 Fallback 与决策过程
管理入口:可观测中心 ➔ LLM运行日志 (/observability/llm-logs)。
实际线上请求触发了路由规则或 Fallback 降级后,可以在调用日志里直接看到完整的尝试链和规则评估过程。
1. 主列表降级标记与多级 Attempt 展开
当请求发生服务端 Fallback 降级时,日志表格的模型列会以 {原模型} ↳ {实际响应模型} 的形式展示(伴随琥珀色指示)。展开该行左侧的折叠箭头,可以看到每一次 Attempt 的顺序记录,包括首跳报错状态码(如 504、429)和耗时,以及最终成功承接的备选模型与耗时。
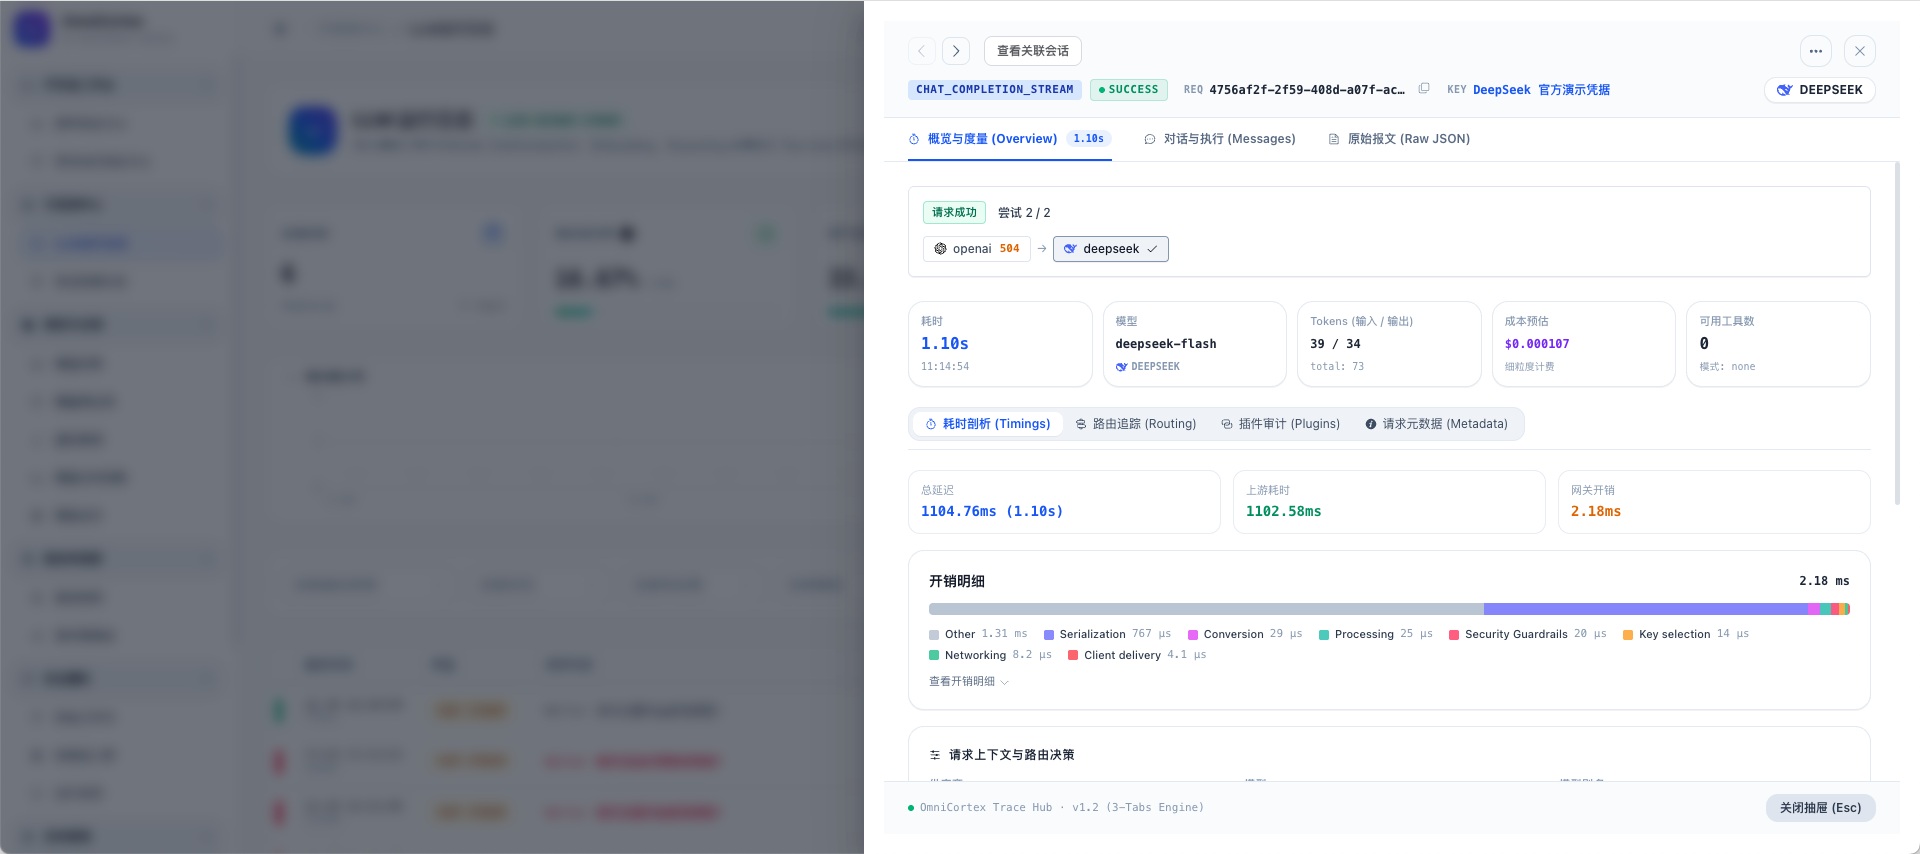
2. 日志详情中的降级横幅与耗时拆分
点开该记录的详情抽屉后,顶部横幅会给出尝试总次数、最终状态以及一条横向步骤流,点击任意步骤可以切换查看该次 Attempt 各自的原始请求与返回内容;下方的时序总览会把首跳等待超时(例如 3000ms)和降级模型实际推理耗时拆开列出,方便区分延迟究竟花在首跳等待还是模型本身响应上。
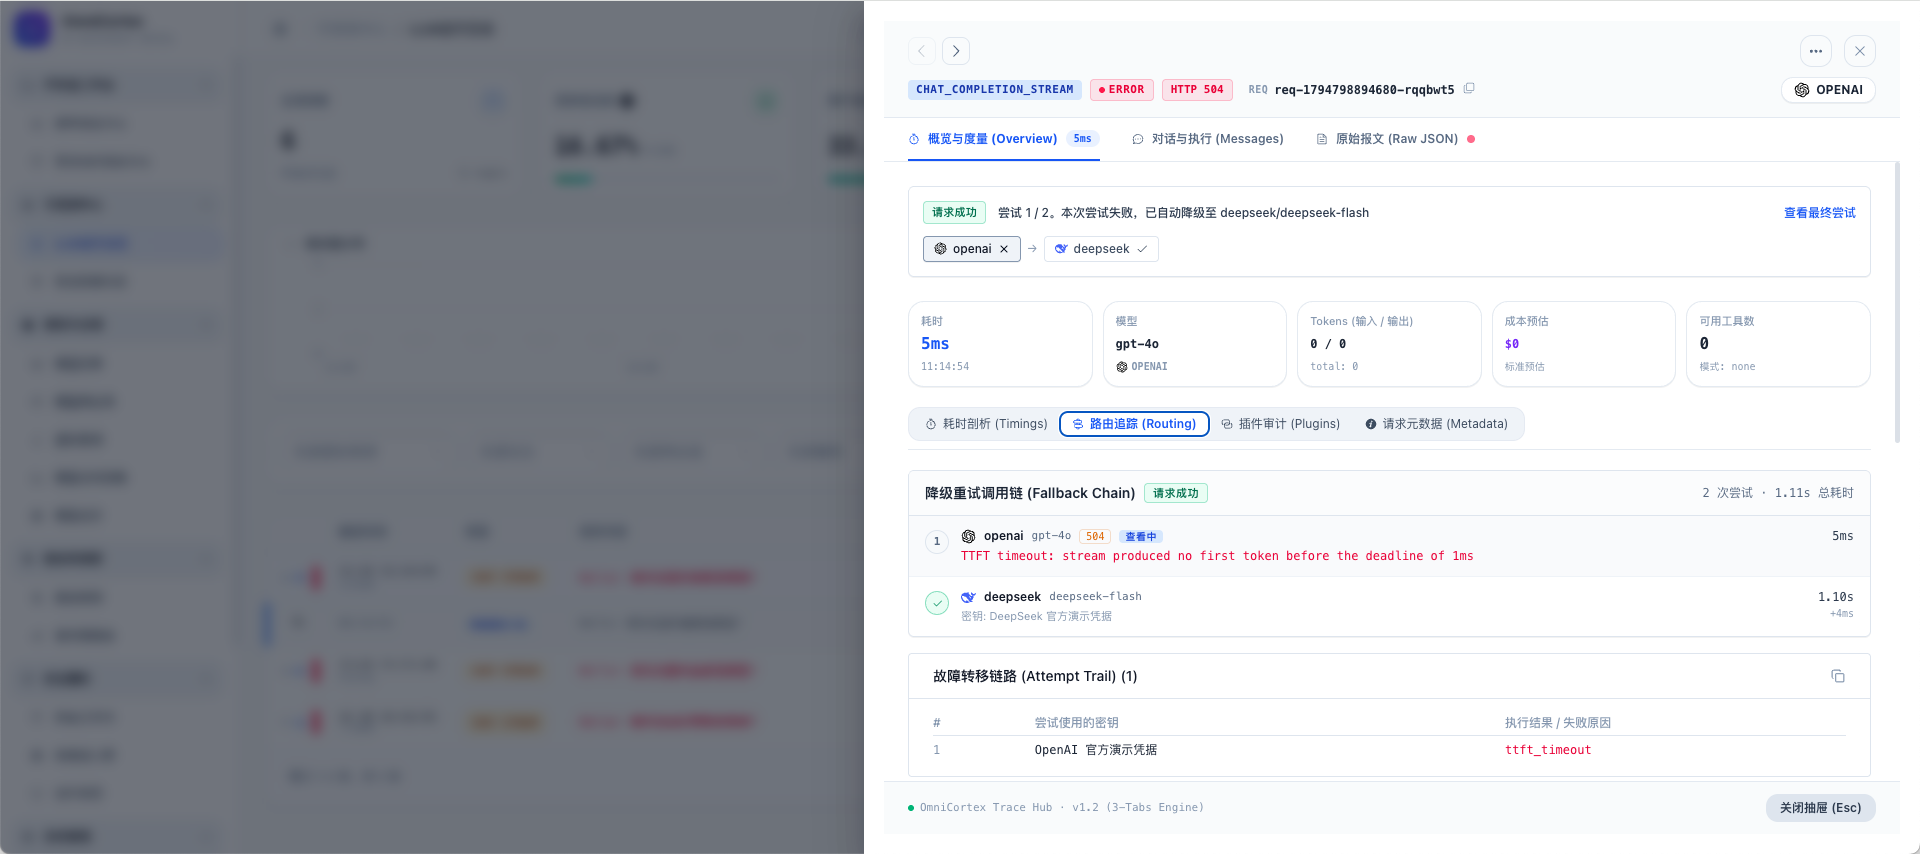
3. 路由追踪视图 (Routing)
展开日志详情的「更多详情」并切到路由追踪 (Routing) 选项卡,可以查看本次请求的完整规则审计数据:
- 尝试链路表:列出每轮尝试选中的物理 API Key(或脱敏 ID)以及执行结果(包含
ttft timeout exceeded等具体中断原因),支持复制原始 JSON。 - 决策拓扑与逐级日志:可切换查看 DAG 流向图或引擎原始评估日志,确认作用域遍历顺序(
virtual_key -> user -> team -> customer -> global)、每条规则为何跳过或命中;如果规则使用了complexity_tier,此处也会记录最终的复杂度分级、判定途径与相似度得分。
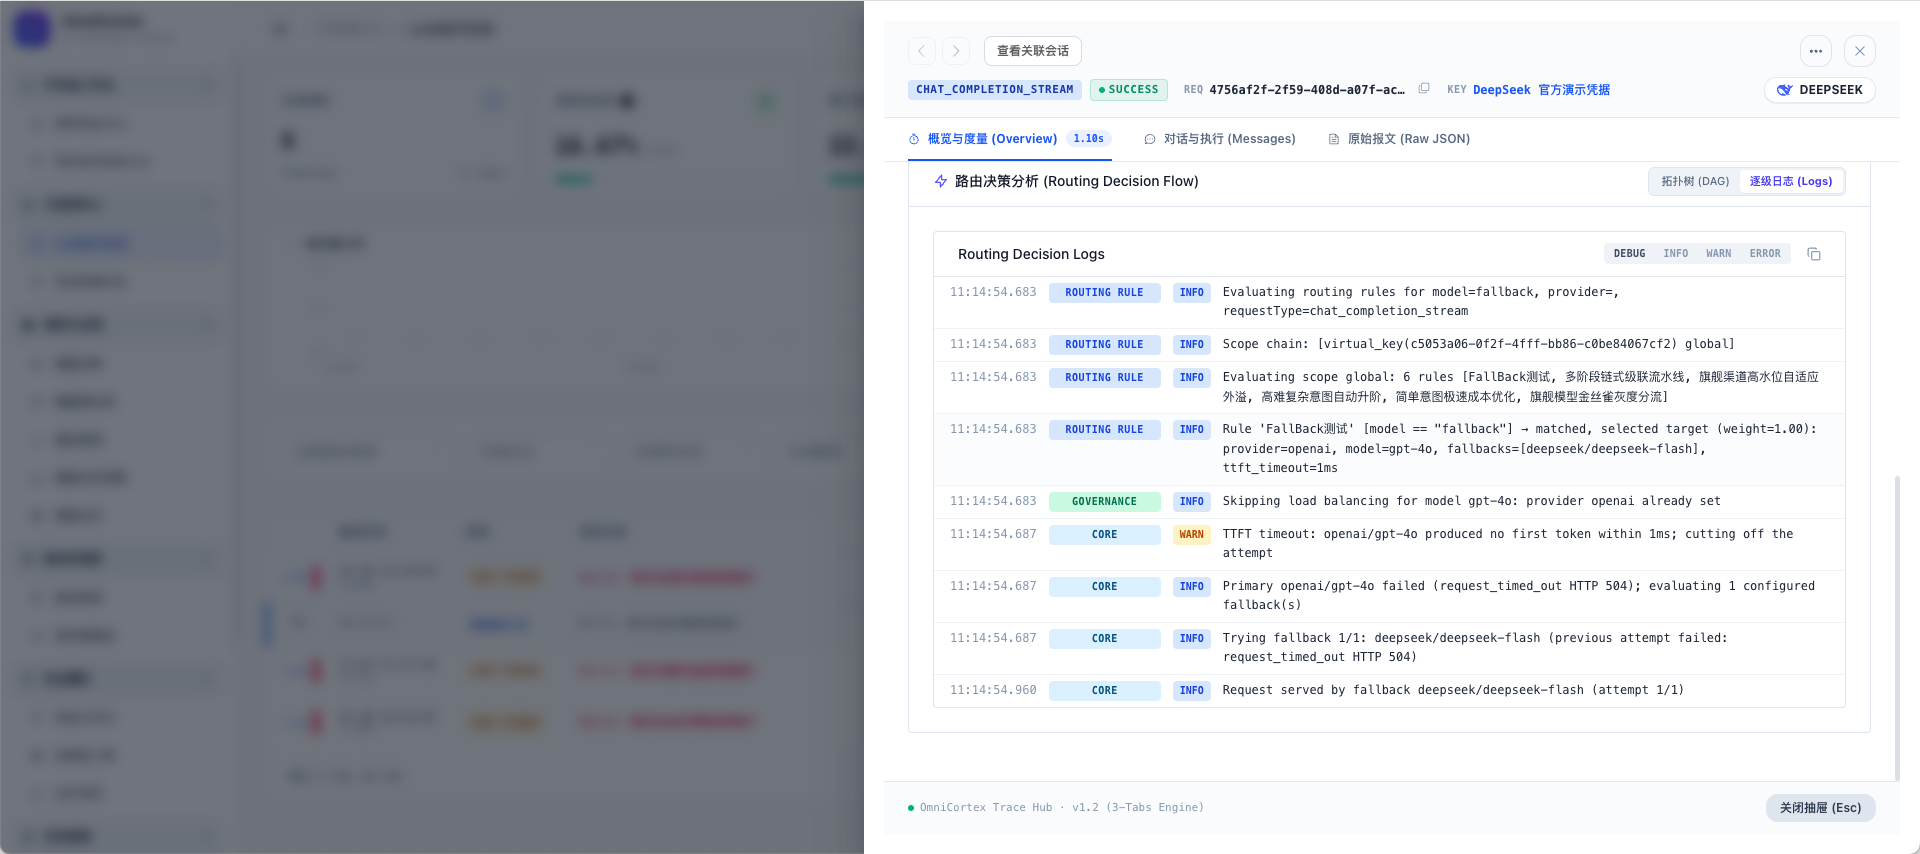
常见异常与故障排查
| 现象 / 报错 | 原因 | 处理方式 |
|---|---|---|
409 ConflictPriority already in use | 同一生效主体(scope + scope_id)下已存在相同 priority 的规则。 | 检查该作用域下已有规则的优先级,更换为未占用的数值(建议按 10 递增预留)。 |
CEL compile errorundeclared reference | 表达式引用了未注册的变量名(例如把日志字段 complexity_mechanism 写进 CEL)、使用了非 CEL 运算符(如 ??),或字符串引号未闭合。 | 对照前文 CEL 变量表 核对字段名,优先用可视化条件构建器生成表达式。 |
| 规则未按预期命中 | 规则引用了请求中未携带的 headers 或 params 键(引擎会将其安全求值为 false);或 request_type 只选了 chat_completion 却发起流式请求(实际为 chat_completion_stream)。 | 打开沙箱调试查看「逐级评估日志」,确认传入上下文变量的真实值与跳过的具体条件。 |
日志出现 Chain exceeded max depth (10) | 多条开启了 chain_rule: true 的规则互相改写形成了链条过长或间接跳转死循环。 | 打开查看拓扑树排查虚线链式流向,确保链尾指向 chain_rule: false 的终端规则。 |
| 流式请求固定在 3s 左右切到 Fallback | 上游模型建立连接后,在 ttft_timeout_ms 设定的 3000ms 内尚未输出首个内容分块,被网关主动截断。 | 对于前置思考耗时较长的推理模型,适当调大对应目标的 ttft_timeout_ms(如 5000)或单独关闭该目标的 TTFT 截断。 |
| 版本回滚后插件加载失败 | 新版存储了对象格式的 fallbacks(包含 provider/model/key_id),旧版仅兼容字符串格式。 | 回滚旧版本前需先将数据库中的对象格式 Fallback 数据整理回 provider/model 字符串格式后再重启。 |