统一模型资产目录
一、 为什么企业需要统一模型资产目录?
1. 核心业务痛点与技术挑战
- 模型命名混乱与影子版本蔓延:企业各业务研发团队在不同工程或 SDK 中随意配置模型别名、非标后缀或遗留弃用版本(如
gpt4、gpt-4-0613、deepseek_v3等),导致网关层路由失配、偶发性 404 错误频发,全局调用行为难以集中管控。 - 存量应用硬编码模型导致发版成本高昂:大量既有生产系统在代码中写死了旧模型标识(如
"model": "gpt-4")。当企业需要引入更新、更强的新模型(如deepseek-chat或私有模型)时,由于牵扯繁琐的代码修改、测试与全量发布流程,难以快速落地。 - 模型上下文窗口与模态能力黑盒化:业务开发者往往无法直观获知特定模型的最大 Token 上下文限制(Context Window),对模型是否支持多模态视觉(Vision)、函数调用(Tool Calls)、结构化输出(Structured Outputs)或深度推理(Reasoning)缺乏统一透明的发现手段,极易在生产运行时发生参数不兼容异常。
- 算力资产缺乏全景台账与版本可见性:企业集中采购了数十款商用大模型,并自建部署了多个私有开源集群,但缺乏中心化的资产全景视图,难以盘点各供应商当前接入的模型总量、能力覆盖度与健康度。
2. 核心能力矩阵与功能价值
| 能力维度 | 传统点对点分散硬编码 | OmniCortex 统一模型资产目录 | 核心能力表现与价值 |
|---|---|---|---|
| 资产全景可见性 | 各业务方私自对接,无中心化模型资产账本 | 提供中心化模型全景看板,聚合各供应商模型分布与状态 | 全局资产透明受控,支持按供应商维度聚合展示支持模型总量与 24h 流量统计。 |
存量代码平替Model Alias Mapping | 切换模型必须修改业务代码并重新构建发版 | 模型别名解耦映射,客户端请求到达后网关静默重写 | 业务代码 0 修改、0 重新发版,老系统无感平替到优质新模型。 |
能力与规格约束Context & Capabilities | 上下文超限靠运行时报错,模态不支持靠盲猜 | 显式声明 Context Window 窗口大小,能力标签自动归一 | 消除运行时调用崩溃,支持自定义添加业务推荐标签(tier, recommended)。 |
元数据自动同步Live Discovery & Sync | 依赖人工手动核对更新,新发布模型无法即刻感知 | 上游元数据自动定期同步,支持秒级即时手动强制刷新 | 前沿模型秒级入库,新发布模型与定价元数据全自动同步更新。 |
二、 业务应用场景与能力落地
场景 1:模型别名解耦映射与存量应用零改动平替 (Model Alias Mapping)
某核心业务系统的微服务集群历史代码中广泛硬编码了 "model": "gpt-4"。因业务需求需要升级为性能更强、响应更快的 deepseek-chat 或企业内部私有模型,但重新打包测试发版需耗费数周时间。
落地效果:网关管理员在模型目录与密钥通道中配置模型别名映射规则 gpt-4 ➔ deepseek-chat。客户端请求到达网关后,网关在亚毫秒内自动完成模型重写并路由至目标供应商,业务系统代码零修改、零重新发版即可无缝享受新模型算力。
场景 2:跨供应商平滑灰度演进与平替验证
企业计划将通用问答场景的主力模型逐步迁移至更适合业务特征的新一代开源微调模型。
落地效果:对外统一定义逻辑别名(如 general-chat)。在模型目录建立标准化实体后,结合底层供应商权重配置,初期将 10% 的逻辑请求分流至候选模型验证效果与稳定性,确认无误后逐步上调分流比例,平滑完成模型换代验证。
场景 3:模态能力发现与平台级推荐标签治理
企业开发团队众多,不同业务线对大模型能力的诉求各不相同(如客服需要高性价比 Chat 模型、风控需要 128k 超大上下文模型、研发助手需要支持 Function Calling 与多模态)。
落地效果:平台管理员在「属性明细」中为各模型标注平台推荐标签(如 tier=production、context_window=128k、recommended=true),为上游虚拟密钥(Virtual Key)白名单与模型访问策略集(Access Profile)提供标准化选型指引,避免业务方错调非标模型。
场景 4:官方元数据自动发现与新发布模型秒级入库
主流大模型厂商(OpenAI、Anthropic、智谱、阿里云等)频繁推出新型号或优化版本。传统网关往往需要停服升级或手动编写繁复的配置。
落地效果:OmniCortex 支持配置在线实时模型发现间隔(如每 60 分钟自动轮询上游源)。上游一旦发布新型号,网关自动拉取并注入目录;在遇到重磅突发发布时,管理员可在控制台一键点击「立即同步」,实现新模型秒级可见可用。
三、 企业控制台实操导览 (Web Console Walkthrough)
1. 功能界面全景
进入 OmniCortex 企业管理控制台,在左侧导航栏点击「模型与治理」→「模型目录」(路由路径:/model/model-catalog),系统呈现包含三大核心 Tab 的统一管理主工作区:
- 资产概览 (Overview):展示全网模型资产统计卡片、供应商聚合分布、近期调用趋势与模型别名映射关系;
- 属性明细 (Attributes):提供全量模型的表格化明细视图,支持按供应商快速筛选、防抖搜索、查阅上下文窗口限制与覆盖价格标签;
- 自动同步 (Sync):集中维护模型元数据源 URL、在线发现轮询周期,并提供即时手动强制拉取按钮。
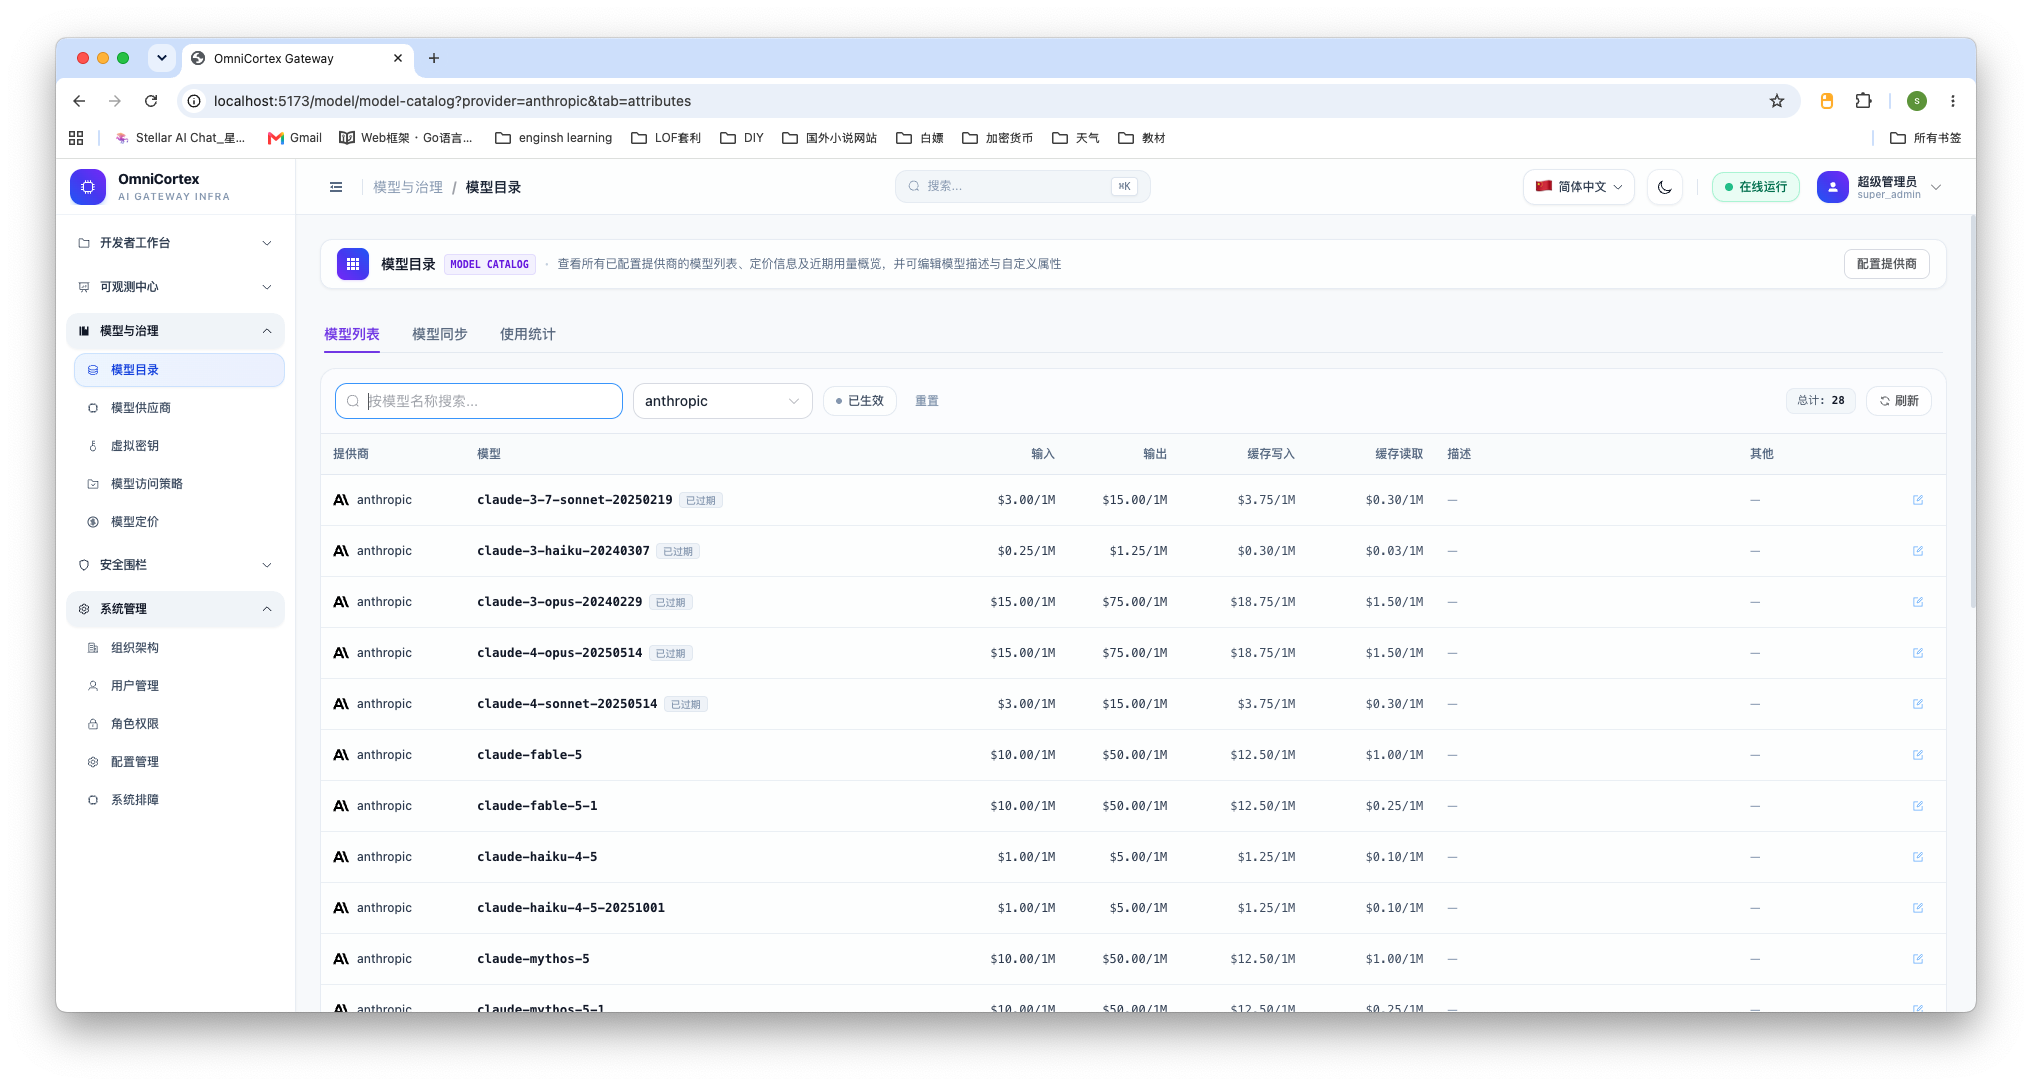
2. 核心操作分步指引 (严格基于前端代码事实)
步骤一:检索模型与查阅规格明细
- 在模型目录顶部 Tab 切换至 属性明细(
AttributesTab)。 - 在表格上方的筛选工具栏中:
- 在搜索框中输入模型关键词(如
deepseek),系统自动执行防抖检索; - 在「按供应商筛选」下拉框中选择指定厂商(如
OpenAI、Anthropic); - 点击「已生效」过滤胶囊,可快速筛选已配置自定义属性或价格覆盖的模型。
- 在搜索框中输入模型关键词(如
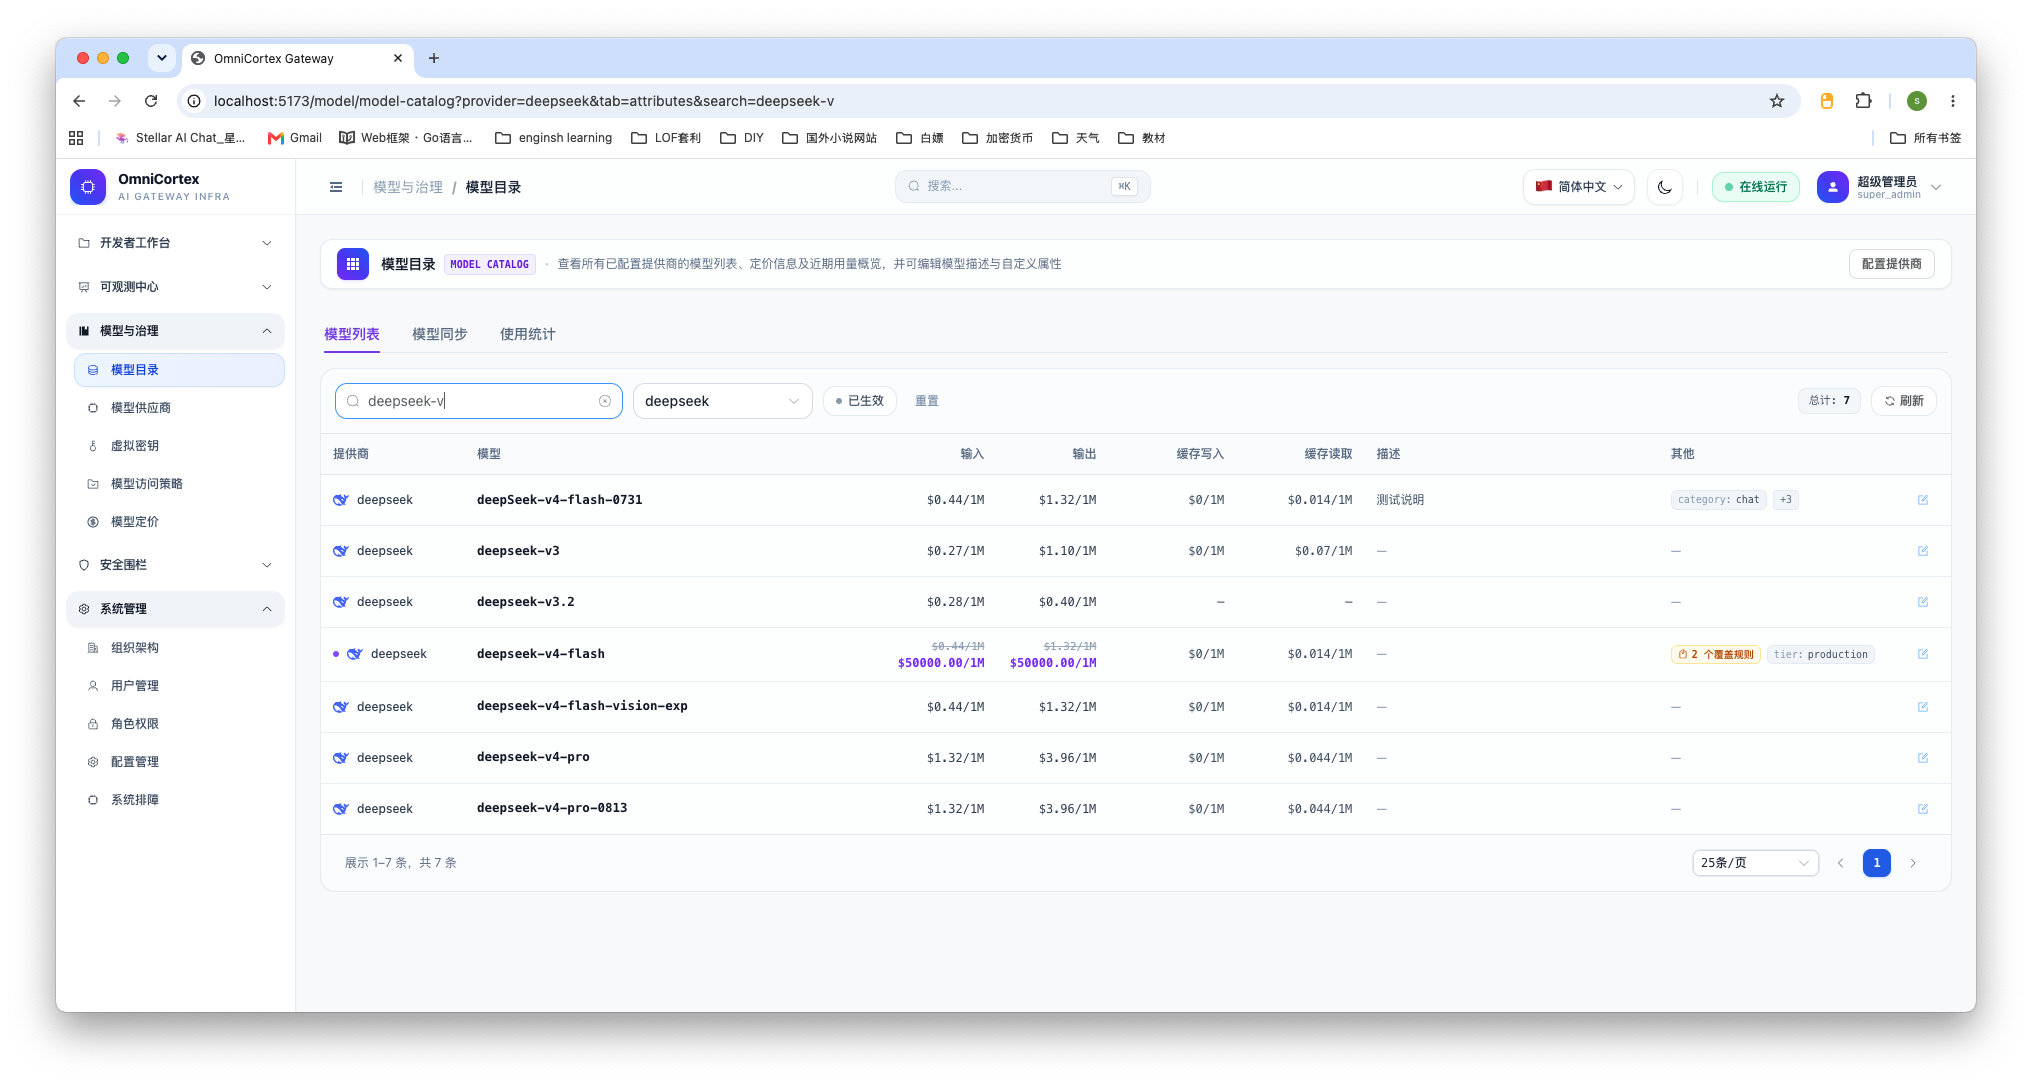
步骤二:微调模型属性与标注业务推荐标签 (AttributeDrawer)
- 在「属性明细」列表中,定位到需要微调的目标模型,点击右侧操作列的 编辑 按钮。
- 屏幕右侧滑出模型属性微调抽屉(
AttributeDrawer)。
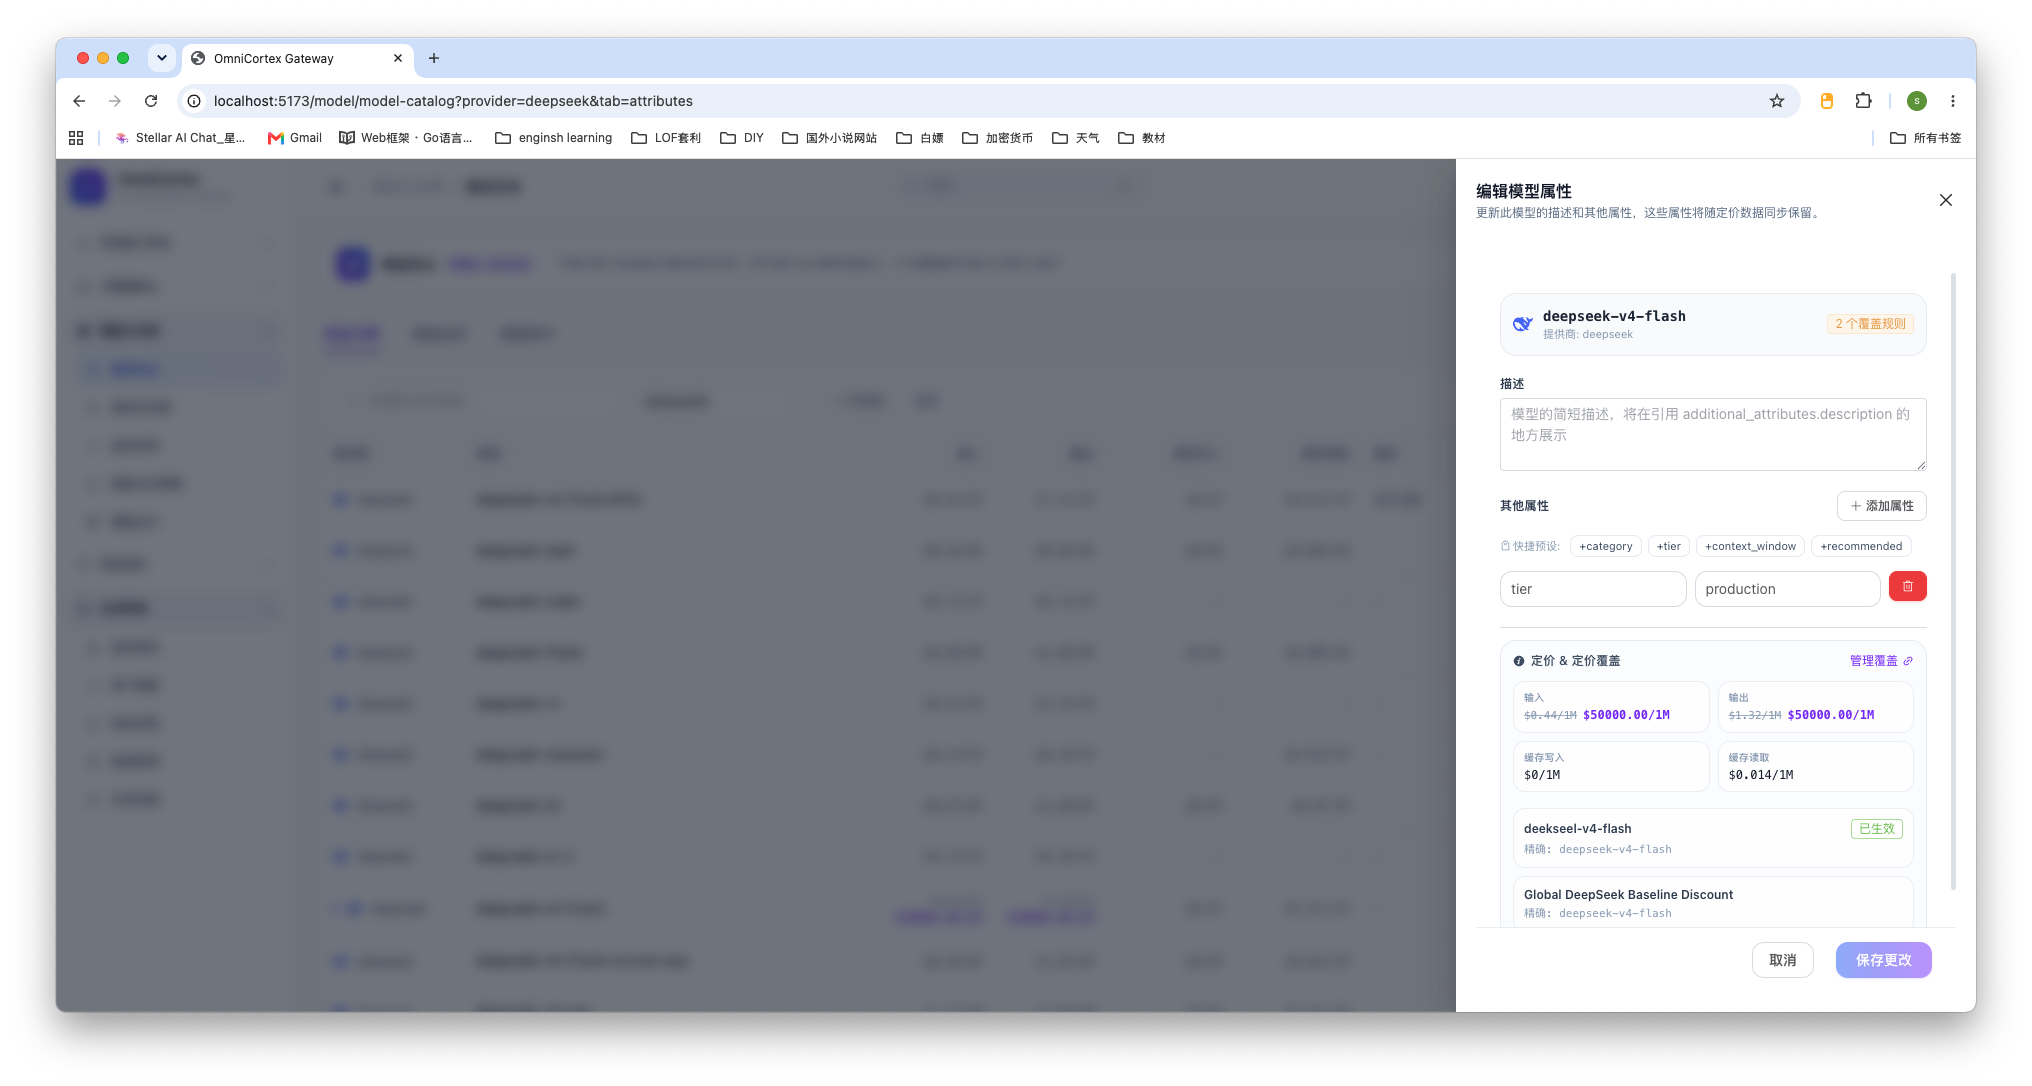
- 在抽屉中填写并调整以下属性配置项:
- 模型业务描述 (
description):补充该模型的企业内部用途定位(如“企业级高可靠主力对话模型”); - 预设推荐标签快捷注入:点击预设按钮,快速填入平台标准化键值对:
category: chat(对话类)tier: production(生产保障级)context_window: 128k(最大上下文长度)recommended: true(平台推荐选用)
- 自定义属性键值对 (
additional_attributes):支持自由点击「+ 添加属性」新增扩展字段(如department: enterprise)。
- 模型业务描述 (
- 确认无误后,点击抽屉底部的 保存属性 按钮,系统提示保存成功并实时生效。
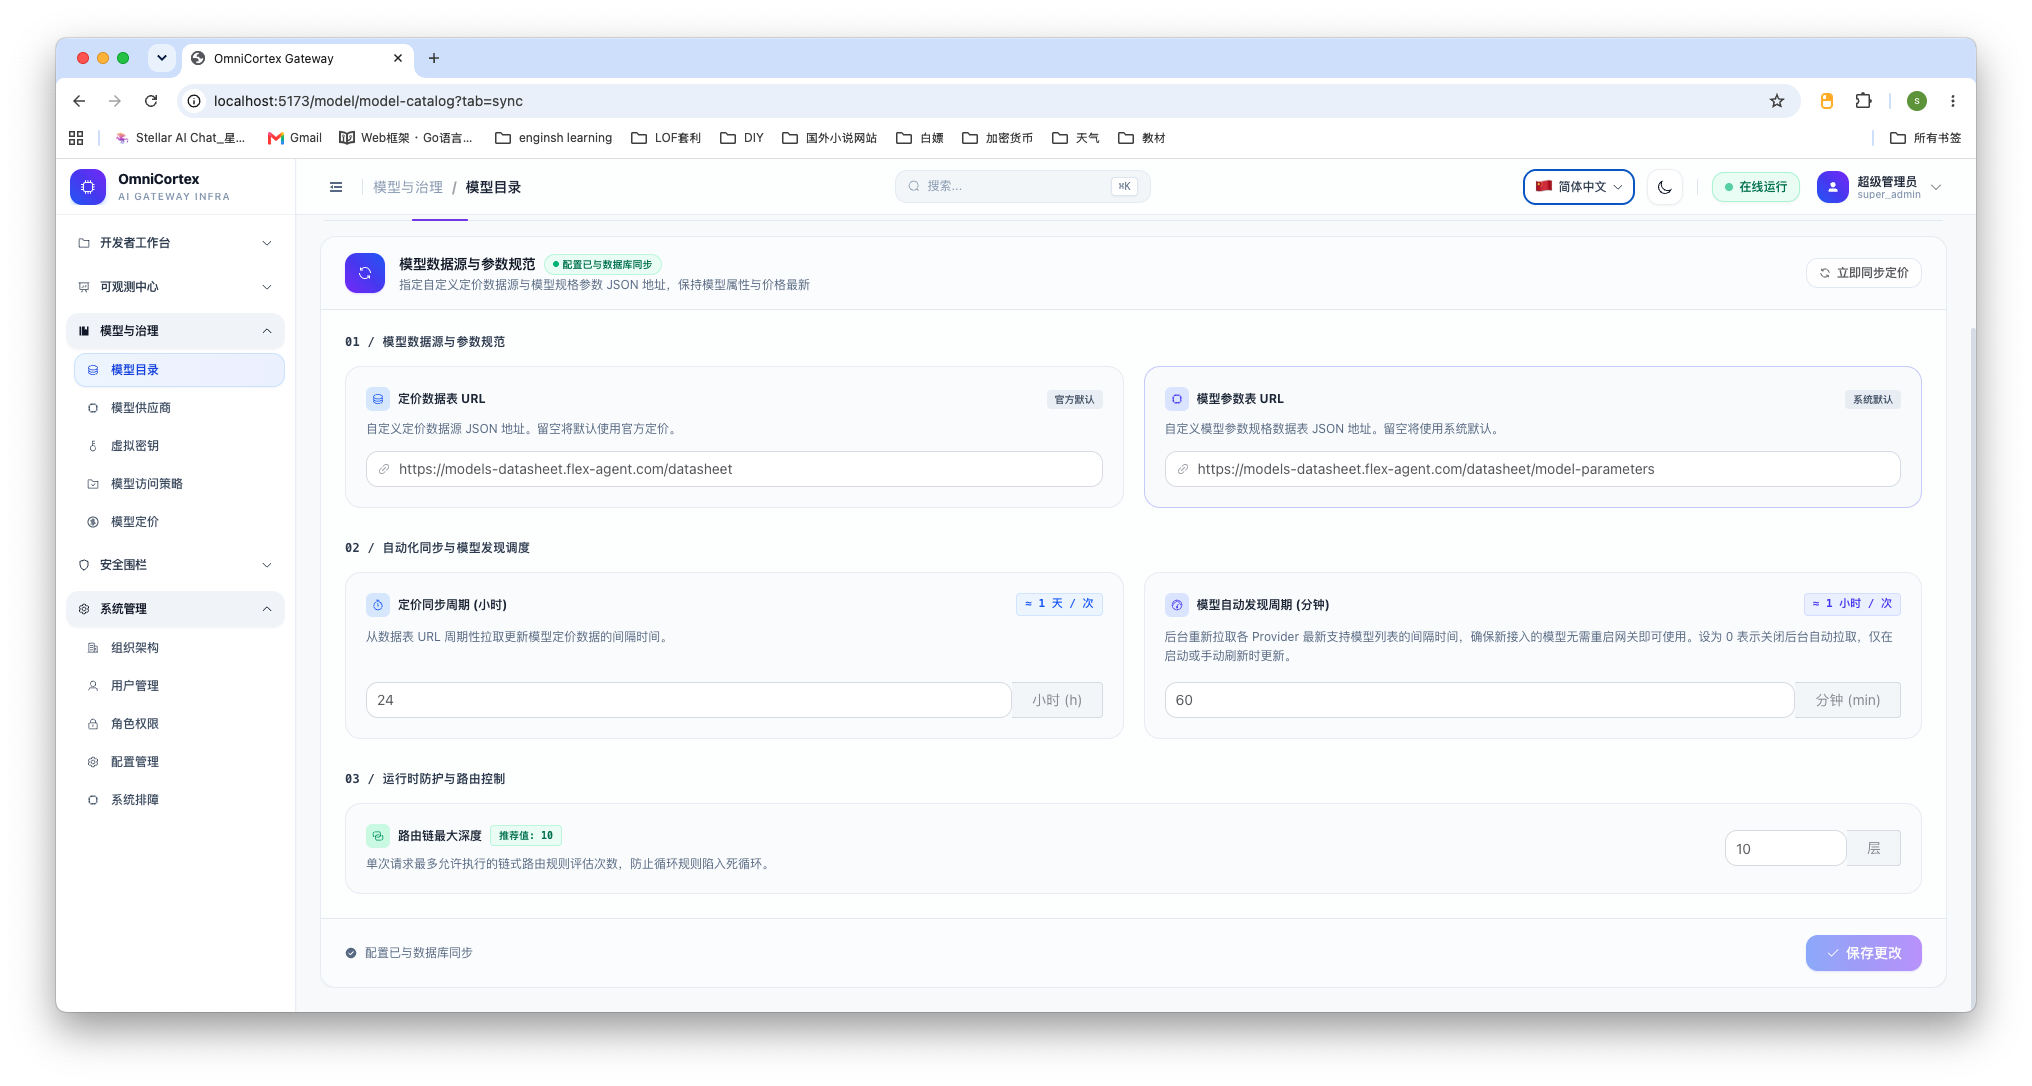
步骤三:配置与触发元数据自动同步 (SyncTab)
- 在模型目录顶部 Tab 切换至 自动同步(
SyncTab)。 - 在该面板中,可对上游元数据的定时同步机制进行精细管控:
- 定价数据源地址 (
pricing_datasheet_url):配置包含全网模型最新公开定价信息的基准元数据 URL(支持 HTTP/HTTPS/File 协议); - 模型规格参数数据源 (
model_parameters_url):配置包含模型上下文长度、模态支持特征的参数源 URL; - 在线模型发现间隔 (
live_models_sync_interval_minutes):设定自动检测上游新上线模型的轮询周期(默认 60 分钟,设为 0 表示禁用); - 路由链最大深度 (
routing_chain_max_depth):防止模型别名或重定向产生死循环的最大深度限制(默认 10)。
- 定价数据源地址 (
- 即时手动同步:若上游服务商刚发布新模型,点击右上角 立即同步模型清单 或 立即同步定价数据 按钮,网关将立即执行后台异步拉取,完成后桌面弹出同步成功通知。
💡 最佳实践指南
- 优先使用统一逻辑别名:在为业务线分配模型权限时,推荐优先使用
general-chat、code-assistant这类面向业务场景的别名,而非直接绑定底层厂商的物理模型 ID。未来无论是模型升级、跨供应商灰度还是故障切换,均可在网关层秒级完成,业务代码完全零感知。 - 规范上下文窗口上限:对于私有化部署的开源模型(如通过 vLLM 部署的 Llama 或 Qwen),务必在模型属性中显式设定准确的
context_window属性,防止业务传入超长上下文导致底层 GPU 显存 OOM。
四、 接口契约与调用实战 (API & Code Examples)
1. 请求鉴权与 Header 规范
OmniCortex 统一模型目录对外完全兼容标准 OpenAI REST API 规范。客户端通过标准的 Bearer Token 即可获取当前可调用的全量标准化模型列表:
| Header 字段 | 类型 | 是否必填 | 描述与范例 |
|---|---|---|---|
Authorization | string | 是 | Bearer sk-xxxxxxxx (企业分配的虚拟密钥) |
Content-Type | string | 是 | application/json |
2. 标准模型列表查询接口 (GET /v1/models)
- 请求方式:
GET http://OMNICORTEX_URL/v1/models - 响应体结构范例 (标准 OpenAI 兼容):
{
  "object": "list",
  "data": [
    {
      "id": "deepseek-chat",
      "object": "model",
      "created": 1700000000,
      "owned_by": "deepseek"
    },
    {
      "id": "gpt-4o",
      "object": "model",
      "created": 1700000000,
      "owned_by": "openai"
    },
    {
      "id": "qwen-max",
      "object": "model",
      "created": 1700000000,
      "owned_by": "aliyun"
    }
  ]
}
3. 多语言接入调用示例
# 1. 查询网关当前可用模型清单
curl -X GET http://OMNICORTEX_URL/v1/models \
  -H "Authorization: Bearer sk-xxxxxxxx"

# 2. 发起标准对话补全(支持使用模型别名,如 general-chat 或 gpt-4)
curl -X POST http://OMNICORTEX_URL/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-xxxxxxxx" \
  -d '{
    "model": "deepseek-chat",
    "messages": [
      {"role": "user", "content": "请简述模型目录在企业级网关中的价值。"}
    ]
}'from openai import OpenAI
# 将端点指向 OmniCortex 网关,传入分配的虚拟凭证
client = OpenAI(
base_url="http://OMNICORTEX_URL/v1",
api_key="sk-xxxxxxxx"
)
# 1. 动态拉取当前网关已纳管的模型列表
models = client.models.list()
print("当前网关支持的模型清单:")
for m in models.data:
print(f" - {m.id} (提供商: {m.owned_by})")
# 2. 调用模型完成推理
response = client.chat.completions.create(
model="deepseek-chat",
messages=[
{"role": "user", "content": "请简述模型目录在企业级网关中的价值。"}
]
)
print("\n模型回复内容:")
print(response.choices[0].message.content)import OpenAI from 'openai';
const client = new OpenAI({
baseURL: 'http://OMNICORTEX_URL/v1',
apiKey: 'sk-xxxxxxxx',
});
async function main() {
// 1. 获取模型资产列表
const modelList = await client.models.list();
console.log('可用模型列表:');
for await (const model of modelList) {
console.log(` - ${model.id}`);
}
// 2. 发起对话推理
const completion = await client.chat.completions.create({
model: 'deepseek-chat',
messages: [{ role: 'user', content: '请简述模型目录在企业级网关中的价值。' }],
});
console.log('\n推理输出:');
console.log(completion.choices[0].message.content);
}
main();package main
import (
"context"
"fmt"
"github.com/sashabaranov/go-openai"
)
func main() {
config := openai.DefaultConfig("sk-xxxxxxxx")
config.BaseURL = "http://OMNICORTEX_URL/v1"
client := openai.NewClientWithConfig(config)
ctx := context.Background()
// 1. 获取模型资产列表
models, err := client.ListModels(ctx)
if err != nil {
panic(fmt.Sprintf("获取模型列表失败: %v", err))
}
fmt.Println("网关可用模型清单:")
for _, m := range models.Models {
fmt.Printf(" - %s (所属: %s)\n", m.ID, m.OwnedBy)
}
// 2. 发起对话请求
resp, err := client.CreateChatCompletion(
ctx,
openai.ChatCompletionRequest{
Model: "deepseek-chat",
Messages: []openai.ChatCompletionMessage{
{Role: openai.ChatMessageRoleUser, Content: "请简述模型目录在企业级网关中的价值。"},
},
},
)
if err != nil {
panic(fmt.Sprintf("推理请求失败: %v", err))
}
fmt.Printf("\n模型回复: %s\n", resp.Choices[0].Message.Content)
}五、 常见异常与故障排查 (Troubleshooting)
在与模型目录及模型元数据交互过程中,若遇到调用异常,可依据下表快速定位处置:
| 异常状态码 / 报错信息 | 典型诱发原因 | 核心排查思路与修复方案 |
|---|---|---|
404 Model Not Found | 1. 业务请求传入的 model 字段拼写错误或包含多余前后缀;2. 该模型尚未在企业模型目录中入库激活; 3. 调用的虚拟凭证绑定的访问策略未勾选该模型。 | 1. 执行 GET /v1/models,确认当前凭据可访问的标准模型 ID 列表;2. 若业务系统代码无法修改模型参数,前往控制台在模型别名中配置平替重写映射; 3. 在「访问策略集」中检查该虚拟密钥是否允许调用该模型。 |
400 Context Length Exceeded | 请求输入的 Prompt 加上 max_tokens 参数总和,超出了模型目录中声明的 Context Window 限制。 | 1. 检查客户端请求入参中的上下文体积与期望输出长度; 2. 在控制台「模型目录」→「属性明细」中查看该模型当前的上下文窗口规格; 3. 如上游实际支持更大上下文,可在微调抽屉中更新该模型的 context_window 声明。 |
502 Upstream Sync Timeout | 网关服务在尝试自动或手动拉取外部官方模型元数据源时发生连接超时或网络阻断。 | 1. 检查网关部署机器是否具备访问外部数据源 URL 的公网出口权限; 2. 若企业部署于严格限制外网的金融级内网,需在「供应商」网络配置中挂载企业合规正向代理(HTTP/SOCKS5); 3. 检查数据源 URL 是否配置正确。 |
401 Unauthorized | 请求未携带 Authorization 请求头,或传入了无效、已过期的虚拟密钥凭证。 | 1. 检查 HTTP 请求头是否按规范传递了 Authorization: Bearer sk-...;2. 在控制台「虚拟密钥」中确认当前凭据状态为活跃(Active)且未达到到期时间 (TTL)。 |